Ver categorias
Explorar
Fiverr Pro
Português
$
USD
Bioinformática: Knockout Molecular Dynamics RNAseq DTA Virtual
Vou validar SMILES de compostos e sequências de proteínas, rodar um modelo de afinidade existente e retornar previsões correspondentes, status por linha, uma tabela ranqueada e notas sobre o modelo/versão. Básico: até 1.000 pares e 20 proteínas.
Rotas disponíveis: DTA bilinear, DeepDTA, GraphDTA e uma variação cross-attention do MolTrans derivada do ChemBERTa com reparo de máscara de comprimento.
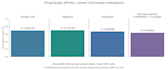
Nossos registros salvos usam rótulos pKi/pKd derivados de BindingDB Ki/Kd, divisões NPZ congeladas e avaliação de target frio (proteínas de teste mantidas fora do treinamento). Índices de concordância: bilinear 0,695145; DeepDTA 0,702238; GraphDTA 0,668996; variação derivada do MolTrans reparada 0,636565. Esses são registros de checkpoint específicos de cada rota, não uma comparação de teste único compartilhado.
Envie amostra de colunas CSV: sample_id, smiles e protein_sequence; adicione compound_id/target_id se disponível. Confirme o modelo e o ranking por alvo. As previsões ajudam a priorização de candidatos.
Pesos e pacotes de implantação em execução podem ser fornecidos por acordo separado após checagem de ativos e distribuição. Vários modelos, retrainings e novas divisões de validação são escopos separados. Me manda mensagem antes de fazer o pedido.

Especialidade:
classificação
•
Análise preditiva
Linguagem de programação:
Python
Frameworks:
PyTorch
