Ver categorias
Explorar
Fiverr Pro
Português
$
USD
Tradução automática
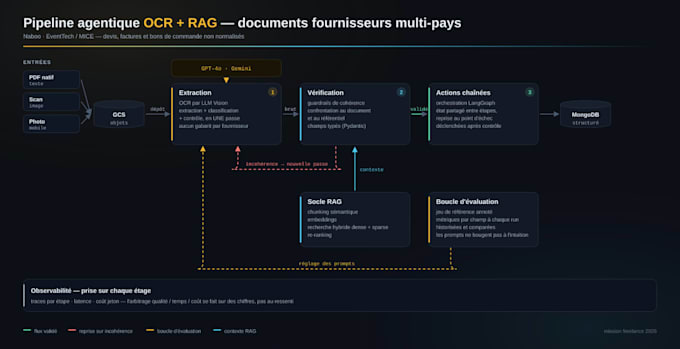
A maioria dos demos de RAG falha na produção porque a recuperação está errada, não o modelo. Eu faço a recuperação certa: chunking semântico, embeddings, busca híbrida densa+sparse, re-ranking - e meço tudo com um conjunto de avaliação, assim cada mudança é um número, não uma impressão.
O que você recebe: um chatbot que responde a partir DOS SEUS documentos, cita suas fontes e diz "não sei" quando deve. Entregue como uma API (FastAPI) com um chat web, Dockerizado, com rastreamento e custo por consulta.
Pilha: Python, LangChain/LangGraph, Qdrant ou Elasticsearch, OpenAI/Gemini/Mistral ou modelos abertos na sua infraestrutura.
Trabalhos recentes: motor RAG em produção para duas marcas de varejo (grupo Mulliez), pipeline OCR+RAG para uma startup de EventTech, motor anti-fraude de documentos para um banco.
Engenheiro sênior de IA, mais de 6 anos, baseado na França. Lidero equipes de 2 a 5 engenheiros.
Senior AI Engineer
Idiomas
Tradução automática
Tradução automática
Qual LLM você usa?
Sua escolha: OpenAI, Gemini, Mistral ou um modelo aberto hospedado na sua infraestrutura para confidencialidade. Recomendo um baseado nos seus documentos e orçamento.
Meus documentos são PDFs escaneados. Isso é um problema?
Não. OCR de visão com LLM faz parte do pipeline: digitalizações, fotos e layouts não padrão são tratados.
Onde o chatbot roda?
Em Docker no seu servidor ou na sua nuvem (GCP, Azure, AWS). Nada fica do meu lado após a entrega.
Como posso saber se funciona?
Você recebe um conjunto de avaliação: suas perguntas, as respostas esperadas e uma pontuação por versão. Cada mudança é medida, não adivinhada.