Ver categorias
Explorar
Fiverr Pro
Português
$
USD

Tradução automática
Você trabalha com documentos confidenciais, contratos legais ou dados proprietários da empresa que não podem ser enviados para APIs na nuvem como OpenAI ou Anthropic?
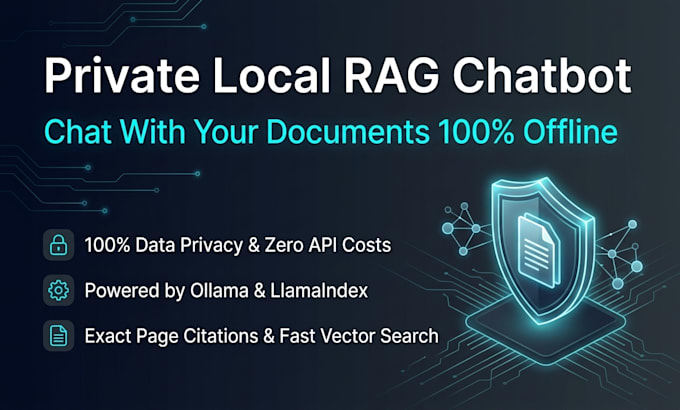
Vou criar um Sistema RAG (Retrieval-Augmented Generation) 100% Privado e Offline que permite conversar com seus documentos localmente no seu laptop ou servidor privado. Sem chaves de API, sem latência na nuvem e total privacidade dos dados.
O que você recebe:
Pilha de tecnologia usada:
Mantenha seus dados totalmente seguros enquanto desbloqueia todo o potencial da IA conversacional com seus arquivos privados!
Data Science and AI Engineer
Idiomas
Tradução automática
Tradução automática
Preciso de conexão à internet para usar esse chatbot?
Não! Depois de instalado, todo o sistema RAG funciona completamente offline na sua máquina, sem solicitações externas à rede.
Que hardware preciso para rodar isso localmente?
Um sistema com 8GB de RAM pode facilmente rodar modelos quantizados de 3B/7B (como Qwen 2.5 ou Llama 3.1). Para desempenho ideal, recomenda-se uma GPU discreta (série NVIDIA RTX).
Isso consegue lidar com arquivos PDF grandes com centenas de páginas?
Sim. O sistema divide e embute seus documentos em um banco de dados vetorial local, permitindo recuperação instantânea independentemente do total de páginas.
