Ver categorias
Explorar
Fiverr Pro
Português
$
USD
Entusiasta de IA
Nível 1
Atendeu a determinados critérios de desempenho e demonstra forte potencial no marketplace.
Precisa de um software que possa detectar, rastrear ou entender o que aparece em imagens ou vídeos?
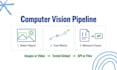
Eu construo pipelines de visão computacional em torno de uma tarefa de negócio clara e os testo com seus exemplos reais. Dependendo do problema, isso pode usar detecção de objetos, segmentação, estimativa de pose, processamento com OpenCV ou um modelo de visão-linguagem que transforma entrada visual em JSON estruturado.
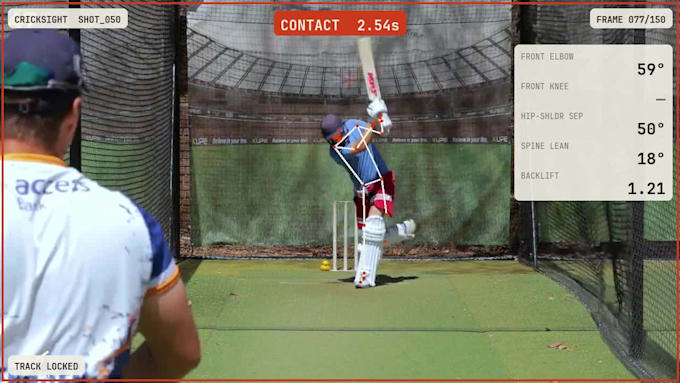
Trabalhos recentes incluem um analisador de vídeos esportivos com rastreamento de pose de 33 pontos, trava no batedor e detecção de quadro de contato. Também criei uma pipeline geoespacial de VLM que revisa imagens de rua, registra o estado de ativos e exporta CSV, GeoJSON e um mapa interativo.
Você pode solicitar ajuda com:
- detecção e rastreamento de objetos
- segmentação ou classificação de imagens
- estimativa de pose e análise de vídeos esportivos
- OCR e extração de dados visuais
- pipelines de VLM para imagens, documentos ou inspeções
- avaliação, entrega de API e implantação
Você recebe código executável, notas de configuração e resultados medidos em uma amostra de teste acordada.
Envie uma descrição curta, eu te direi qual pacote se encaixa e o que pode ser medido.
Tradução automática
Você consegue treinar YOLO no meu dataset?
Sim, quando o YOLO se encaixar na tarefa. Primeiro verifico a qualidade das labels, o equilíbrio das classes e o dispositivo alvo. O cálculo de treinamento e a anotação são orçados separadamente quando excedem o pacote escolhido.
Você constrói workflows de modelos de visão-linguagem?
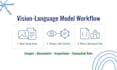
Sim. Posso usar um VLM para descrever, classificar ou extrair campos estruturados de imagens e documentos. Adiciono verificações de schema e gerenciamento de confiança para que casos incertos possam ser revisados.
Você consegue analisar vídeos em tempo real?
Possivelmente. Compartilhe o hardware alvo, resolução, taxa de quadros e objetivo de latência. O desempenho em tempo real depende do modelo, streaming e dispositivo, então faço testes de performance antes de prometer.
Você garante uma pontuação de precisão?
Concordarei com um conjunto de teste e reportarei o resultado medido. Um objetivo útil depende da qualidade dos dados, definições de classes e do custo de cada erro.
Preciso de dados rotulados?
Nem para todo trabalho. Um VLM ou modelo existente pode funcionar sem treinamento personalizado. Se labels forem necessárias, posso definir o formato de anotação e estimar o esforço.