Ver categorias
Explorar
Fiverr Pro
Português
$
USD
Desenvolvedor Full Stack React, Angular, WP, Engenheiro de Visão Computacional
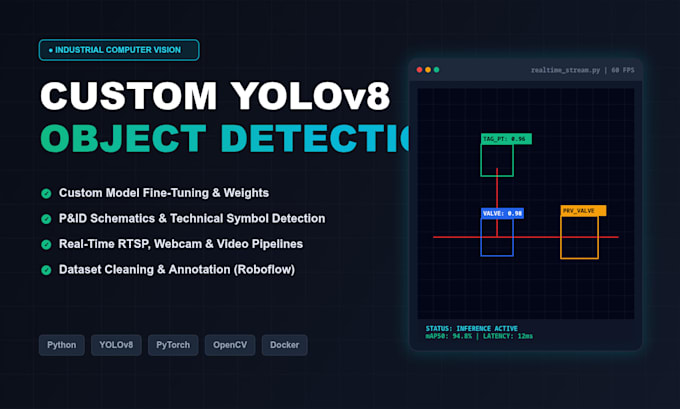
Procurando uma solução pronta para produção de Visão Computacional e Detecção de Objetos? Eu me especializo em treinar, otimizar e implantar modelos YOLO de alto desempenho, personalizados de acordo com suas especificações.
Com experiência industrial ajustando arquiteturas YOLO em conjuntos de dados do mundo real na Larsen & Toubro Construction, entrego pipelines robustos feitos para precisão e baixa latência.
Serviços oferecidos:
Pilha tecnológica: Python, YOLOv8, PyTorch, OpenCV, Roboflow, CUDA, Docker
Por que escolher este serviço?
Por favor, envie uma mensagem com detalhes do seu conjunto de dados e requisitos do projeto antes de fazer seu pedido para garantir a melhor abordagem técnica!
Especialidade:
processamento de imagem
•
Detecção de objetos
Linguagem de programação:
Python
•
Colab
Ferramentas:
caderno Jupyter
•
opencv
•
PyTorch
Frameworks:
Scikit-learn
•
keras
•
PyTorch
•
Panda
Tradução automática
O que preciso fornecer antes de iniciar o projeto?
Forneça uma descrição breve dos objetos que deseja detectar, o ambiente alvo (webcam, CCTV, arquivos de vídeo) e seu conjunto de dados (imagens ou vídeos). Se ainda não tiver um conjunto de dados anotado, escolha o pacote Standard ou Premium para que a limpeza e anotação do conjunto de dados sejam feitas para você
E se meu conjunto de dados for pequeno ou ainda não estiver rotulado?
Nos pacotes Standard e Premium, as imagens brutas são limpas, anotadas com caixas delimitadoras e aumentadas usando Roboflow e OpenCV para ampliar a diversidade do conjunto de dados e melhorar a generalização do modelo.
Como vou rodar e testar o modelo no meu computador?
Cada pacote fornece código fonte Python limpo e modular, pesos do modelo treinados .pt, um arquivo de requisitos e documentação clara de configuração. Você receberá um script de inferência simples para testar a detecção em imagens, vídeos ou na sua webcam ao vivo imediatamente.
Preciso de uma GPU cara para rodar o modelo?
O treinamento é feito em hardware dedicado (como ambientes CUDA/PyTorch), mas o modelo exportado pode rodar inferência em CPUs padrão, GPUs locais ou servidores na nuvem. Se você precisa de baixa latência, o modelo também pode ser otimizado ou containerizado via Docker para implantação leve.
Podemos discutir requisitos personalizados antes de fazer o pedido?
Sim. Clique no botão Contate o vendedor para enviar o escopo do seu projeto, imagens de exemplo ou casos específicos antes de fazer seu pedido, assim podemos confirmar a arquitetura e o nível adequados.