Ver categorias
Português
$
USD
Conecte-se à sua IA
Tradução automática
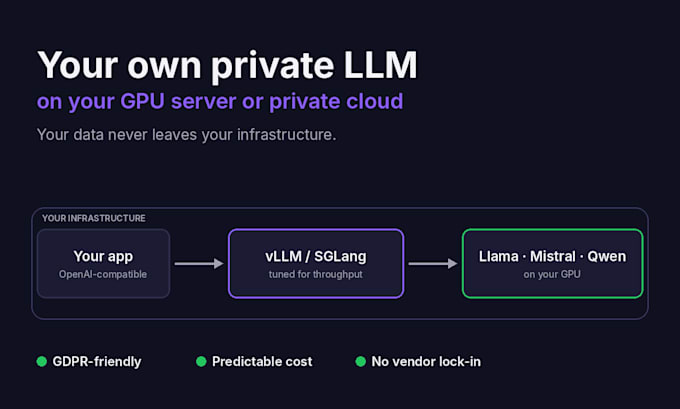
Quer IA no nível do ChatGPT sem enviar seus dados para a OpenAI? Vou implementar um LLM de código aberto no seu próprio servidor GPU ou na nuvem privada, para que prompts e documentos nunca saiam da sua infraestrutura.
Sou engenheiro de IA que criou e gerenciou uma plataforma soberana de IA em produção para uma empresa holandesa de hosting com mais de 1,4 milhão de assinaturas. Isso é engenharia de inferência real, não uma simples instalação Ollama com um clique.
O que eu faço:
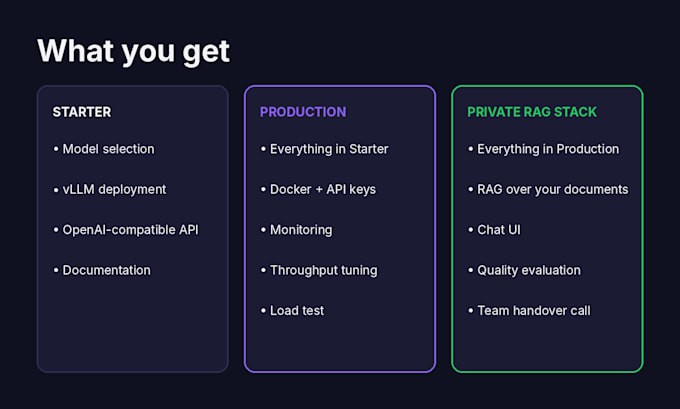
Escolho o modelo certo para a sua tarefa e hardware (Llama, Mistral, Qwen, DeepSeek, Gemma)
Implemente com vLLM ou SGLang por trás de uma API compatível com OpenAI, para que o seu código existente funcione só funciona
Ajusto throughput, latência e memória da GPU (quantização, KV cache, batching)
Adiciono Docker, chaves de API, monitoramento e testes de carga para tráfego real
Opcional: RAG sobre seus próprios documentos com uma interface de chat
É uma boa opção se:
Você tem requisitos de privacidade, GDPR ou conformidade
Você paga caro por tokens de API e quer custos previsíveis
Já tem GPUs (on-prem, RunPod, Lambda, AWS, Hetzner) ou precisa de ajuda para escolhê-las
Por favor, me mande uma mensagem antes de fazer o pedido com seu caso de uso e o hardware, para eu confirmar o pacote certo.
Senior AIML Engineer
Idiomas
Tradução automática
Tradução automática
Preciso de minha própria GPU?
Você precisa de acesso a um servidor com GPU: on-prem, ou alugado de provedores como RunPod, Lambda, AWS ou Hetzner. Se ainda não tiver, vou indicar a GPU certa e o provedor ideal para o seu modelo e orçamento antes de você fazer o pedido.
Vai funcionar com o seu código existente da OpenAI?
Sim. A implantação expõe uma API compatível com OpenAI, então na maioria dos casos você só precisa alterar a URL base e o nome do modelo no seu código.
Qual modelo eu devo usar?
Depende da sua tarefa, da língua e da memória da GPU. Recomendo um modelo (ex.: Llama, Mistral, Qwen, DeepSeek ou Gemma) e o nível de quantização para obter a melhor qualidade que seu hardware consegue rodar rápido.
Como você acessa meu servidor?
Acesso temporário via SSH ou conta na nuvem com apenas as permissões necessárias. Você pode remover meu acesso assim que o trabalho for entregue.
Um modelo self-hosted pode ser tão bom quanto o GPT-4?
Para tarefas focadas como Q&A de documentos, sumarização ou classificação, modelos abertos modernos costumam chegar perto. Para raciocínio amplo, eles podem ficar para trás. Vou ser honesto sobre o que esperar para o seu caso antes de começarmos.