Ver categorias
Explorar
Fiverr Pro
Português
$
USD

Tradução automática
Pare de confiar em chatbots de IA que criam fantasias. para obter valor real de negócios com Large Language Models, eles precisam entender SEUS dados.
eu projeto agentes de IA personalizados em produção e pipelines de Retrieval-Augmented Generation (RAG) que se integram com segurança à sua base de conhecimento corporativa proprietária.
como engenheiro principal de IA/ML, eu me especializo em levar a IA de cadernos experimentais para aplicações de software altamente escaláveis. em implantações comerciais anteriores, minhas arquiteturas personalizadas de LLM aumentaram o engajamento dos usuários em 40%.
o que eu construo:
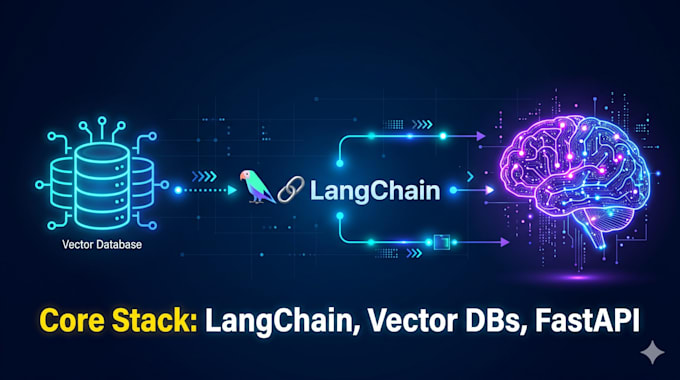
Stack: Python, LangChain, OpenAI, FastAPI, Vector DBs, AWS.
envie-me uma mensagem com seus objetivos do projeto e vamos começar!
Generative AI, RAG, and Edge Computing Expert
Idiomas
Tradução automática
Tradução automática
Meu dado proprietário é seguro? Será usado para treinar modelos públicos?
Sim, seus dados são totalmente seguros. Eu valido pipelines RAG usando APIs de nível empresarial e Vector Databases dedicados. Seus documentos são usados estritamente para recuperação de contexto e nunca são usados para treinar modelos base como o GPT público da OpenAI.
Como isso é diferente de usar apenas o ChatGPT padrão?
LLMs padrão costumam fantasiar fatos e não têm conhecimento das suas operações internas. um pipeline RAG personalizado restringe a IA a buscar respostas apenas nos documentos ou bancos de dados específicos que você fornece, garantindo respostas altamente precisas e factuais.
Que tipo de dados ou documentos a IA pode processar?
Posso integrar uma ampla variedade de fontes de dados, incluindo PDFs, arquivos CSV/Excel, bancos de dados SQL, documentos do Word e wikis internos como Notion ou Confluence.
Qual stack de tecnologia você usa para construir o backend?
Eu elaboro esses sistemas usando Python, LangChain e LangGraph para os fluxos de IA. Para a infraestrutura de backend, uso FastAPI e Redis para garantir que a aplicação consiga lidar com alto tráfego (30+ RPS) com baixa latência, containerizado com Docker.
Você ajuda a implantar o agente na nuvem?
Sim. se você escolher o pacote Premium Enterprise, eu forneço uma configuração de Docker totalmente containerizada e configuração de implantação. ficará totalmente pronto para hospedar no provedor de nuvem de sua preferência, como AWS, GCP ou Azure.