Ver categorias
Explorar
Fiverr Pro
Português
$
USD
Engenheiro de QA, QA de IA, Testes manuais, Testes de API, Automação
A sua aplicação de IA está dando respostas incorretas, inconsistentes ou inesperadas?
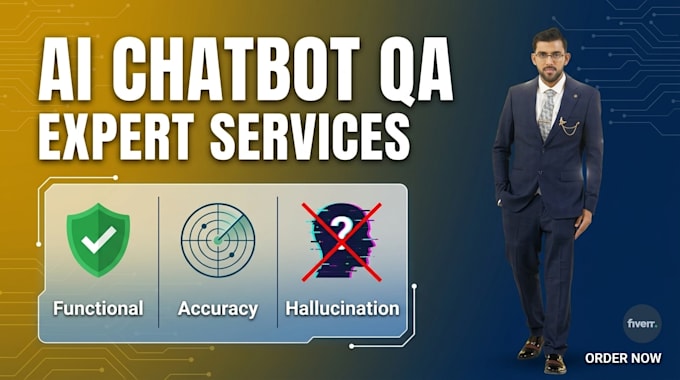
Vou testar profissionalmente seu chatbot de IA, agente de IA, aplicação RAG ou recurso alimentado por LLM, tanto do ponto de vista de QA de software quanto de testes de IA.
Posso testar:
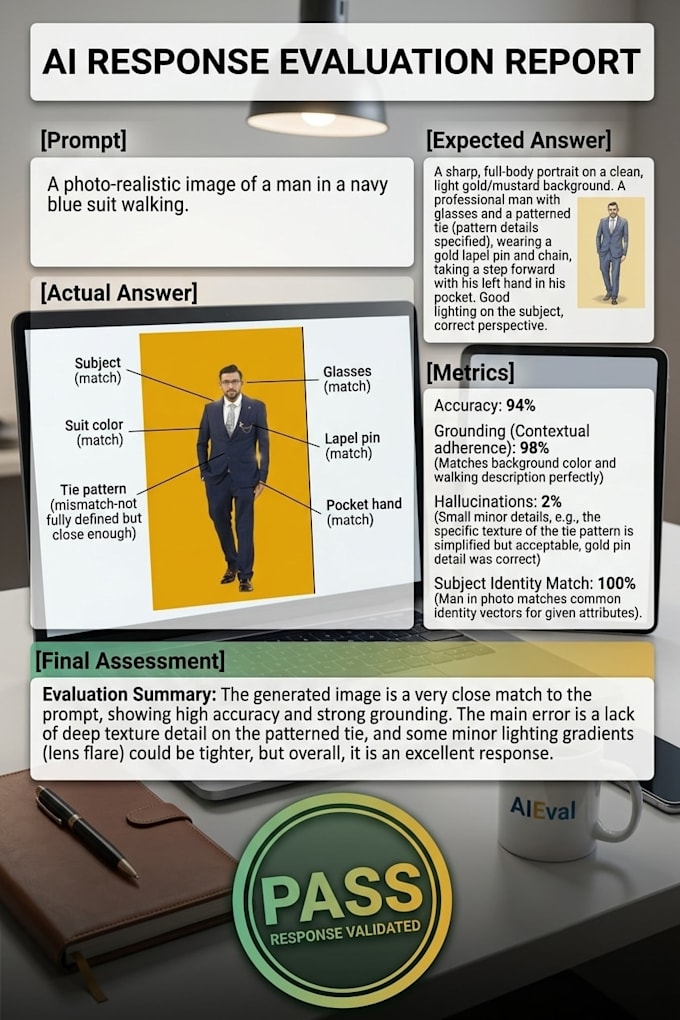
Você receberá relatórios de bugs claros com:
Foco tanto na qualidade do software quanto na confiabilidade da IA, para que sua aplicação seja mais segura e confiável para os usuários finais.
Por favor, envie os detalhes da sua aplicação de IA antes de fazer o pedido.

Aplicação de teste:
Outros
Tecnologia de desenvolvimento:
Python
Dispositivo:
PC
Tradução automática
Quais aplicações de IA você pode testar?
Posso testar chatbots de IA, aplicações de LLM, agentes de IA, sistemas RAG, fluxos de trabalho com IA e recursos de IA dentro de aplicações web.
Você testa alucinações?
Sim. Posso criar cenários feitos para identificar respostas não suportadas, incorretas, contraditórias ou fabricadas.
Você consegue testar aplicações RAG?
Sim. Posso avaliar relevância de recuperação, precisão das respostas, fundamentação, falta de contexto e respostas não suportadas.
Você consegue testar agentes de IA?
Sim. Posso testar seleção de ferramentas, chamadas de API, execução de fluxo de trabalho, entradas inesperadas, tratamento de falhas e respostas finais.
Você fornece um relatório de QA?
Sim. O relatório pode incluir áreas testadas, cenários que falharam, defeitos, severidade/prioridade e evidências de suporte.