Ver categorias
Português
$
USD
Conecte-se à sua IA
Full Stack Web, DevOps e Automação IA, The Burujan
As perdas por fraude machucam, mas alarmes falsos que bloqueiam clientes bons também. Eu crio um modelo de detecção de fraude com aprendizado de máquina em Python que pega mais fraudes e sinaliza menos clientes reais.
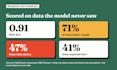
Sou Huzaifa, da The Burujan, engenheiro de NOC que cria projetos de ciência de dados. Meu projeto de detecção de fraude com cartão de crédito usa 590.540 transações reais, em que apenas 3,5% são fraude. Em um conjunto de teste posterior, o modelo nunca tinha visto, atingiu 0,91 ROC AUC, capturou 71% dos dólares de fraude e reduziu alarmes falsos em 47% em comparação com um modelo padrão com a mesma captura de fraude.
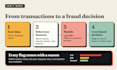
O que você recebe: limpeza de dados, features de comportamento como histórico de gastos e velocidade, tratamento de desequilíbrio de classes, modelos LightGBM e XGBoost ajustados, um limiar de decisão baseado no seu custo de fraude versus um alarme falso, explicações SHAP para que analistas vejam por que cada transação foi marcada, e um relatório com um notebook Jupyter. Premium adiciona uma API de scoring, plano de monitoramento e guia de retraining.
Divido os dados por tempo, não aleatoriamente, então os resultados são justos. Nenhum modelo pode prometer zero fraude, e os resultados dependem dos seus dados. Envie-me uma mensagem antes de pedir com uma descrição curta dos seus dados e eu digo se eles servem.
Linguagem de programação:
Python
•
SQL
Frameworks:
Scikit-learn
Ferramentas:
caderno Jupyter
•
Colab
Tradução automática
Quais dados preciso fornecer?
Uma tabela de transações passadas com um rótulo de fraude (0 ou 1), em CSV ou exportação de banco de dados. Vários meses de histórico com carimbos de tempo e valores funcionam melhor. Campos de cartão, dispositivo e e-mail ajudam, mas são opcionais.
O modelo realmente reduz alarmes falsos?
No meu projeto, reduziu alarmes falsos em 47% em comparação com um modelo padrão na mesma captura de fraude em um conjunto de teste posterior. Os resultados dependem dos seus dados, então eu reporto as mesmas métricas nos seus dados retidos.
Você pode implantá-lo como uma API?
Sim. O pacote Premium inclui uma API de scoring com notas de handover. Eu trabalho em Python com LightGBM, XGBoost e scikit-learn, e posso adaptar sua stack se você me disser o que usa.


