Ver categorias
Explorar
Fiverr Pro
Português
$
USD


Tradução automática
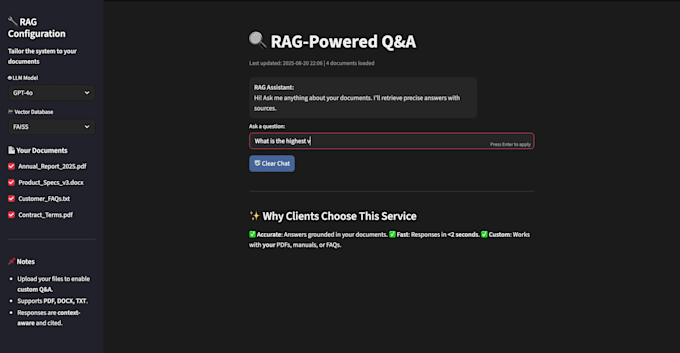
Quer turbinar suas aplicações de IA com Retrieval-Augmented Generation (RAG)? Você está no lugar certo!
Vou projetar e implementar um pipeline de RAG pronto para produção que combina o poder de Modelos de Linguagem Grande (LLMs) com sistemas de recuperação inteligentes, permitindo que sua IA forneça respostas precisas, contextuais e atualizadas.
O que eu ofereço:
Desenvolvimento completo de pipeline de RAG (recuperador + gerador)
Integração com bancos de dados vetoriais (Pinecone, Weaviate, FAISS, Milvus, etc.)
Ingestão de documentos e segmentação com embeddings
Implantação pronta para API (FastAPI/Flask)
Fine-tuning para casos de uso específicos
Integração de IA explicável para transparência
Otimização para escalabilidade e latência
Casos de uso:
Por que me escolher?
Como engenheiro especialista em ML/IA e desenvolvedor Python, já criei soluções de RAG do mundo real que são escaláveis, flexíveis e personalizadas às necessidades do seu negócio. Garanto código limpo, documentado e pronto para produção para que você possa escalar com confiança.
Hi, I'm Tauseef Ahmed, an AI ML engineer with 7 years of experience
Idiomas
Tradução automática
Tradução automática
O que é uma solução RAG?
Uma solução RAG (Retrieval-Augmented Generation) combina um recuperador (busca de conhecimento relevante de um banco de dados) com um gerador (LLM como GPT) para fornecer respostas precisas, contextuais e confiáveis.
Por que preciso de RAG em vez de um LLM normal?
LLMs padrão podem criar respostas fantasiosas ou desatualizadas. Com RAG, sua IA tem acesso a conhecimento em tempo real e específico do domínio, garantindo correção, confiabilidade e menos alucinações.
Quais bancos de dados vetoriais você suporta?
Suporto Pinecone, Weaviate, FAISS, Milvus, Chroma e ElasticSearch. Se tiver outro em mente, posso integrar também.
Você consegue implantar a solução em produção?
Sim! Posso implantar seu pipeline de RAG como uma API (FastAPI/Flask), integrá-la a chatbots ou aplicativos web, e configurá-la para escalabilidade em ambientes de nuvem (AWS, GCP, Azure, etc.) (Plano específico apenas).
Preciso de meu próprio LLM ou podemos usar OpenAI/Outros?
Ambos são possíveis! Posso integrar modelos da OpenAI, Anthropic, Cohere, HuggingFace ou seu próprio LLM ajustado, dependendo das suas necessidades.
Você consegue deixar o domínio específico (jurídico, médico, financeiro, etc.)?
Com certeza ✅. Posso ajustar embeddings, lógica de recuperação e configuração do pipeline para aplicações específicas do seu setor, garantindo que sua solução de RAG se encaixe na sua indústria.
Como você garante a privacidade e segurança dos dados?
Uso pipelines seguras, bancos de dados vetoriais privados e APIs com controle de acesso para proteger seus dados sensíveis. A implantação pode ser feita nos seus servidores ou contas na nuvem para controle total.
O que preciso para começar?
Basta compartilhar seus requisitos, dados disponíveis (documentos, base de conhecimento, etc.) e tecnologia preferida. Eu te guio no restante!