Ver categorias
Português
$
USD
Conecte-se à sua IA
Engenheiro IA, LLM, RAG e NLP Developer
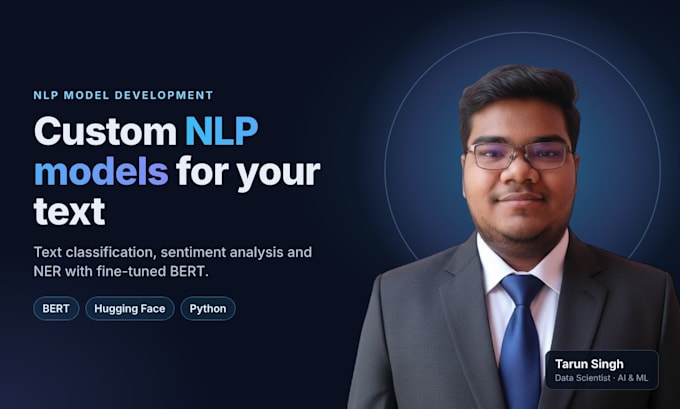
Precisa de um modelo que entenda seu texto: avaliações, tickets de suporte, e-mails, comentários ou documentos?
Eu crio e ajusto modelos NLP com BERT, RoBERTa e DistilBERT que transformam texto cru em previsões precisas.
O que posso construir:
O que você recebe:
Por que comigo?
Sou cientista de dados trabalhando com NLP e LLMs todo dia. Fine-tunei MobileBERT para 91,9% de acurácia em detecção de emoções com 6 classes, depois reduzi o tamanho pela quantização mantendo 91,1%. No trabalho, construo pipelines LangChain LLM e serviços FastAPI que rodam em produção.
Me manda sua data e objetivo antes de fechar o pedido, que eu sugiro o pacote certo.
Linguagem de programação:
Python
•
SQL
•
Colab
•
NoSQL
•
MLflow
Frameworks:
Scikit-learn
•
keras
•
PyTorch
•
Panda
Ferramentas:
caderno Jupyter
•
fluxo tensor
•
Excel
•
MLflow
•
Colab
Tradução automática
Quais dados preciso fornecer?
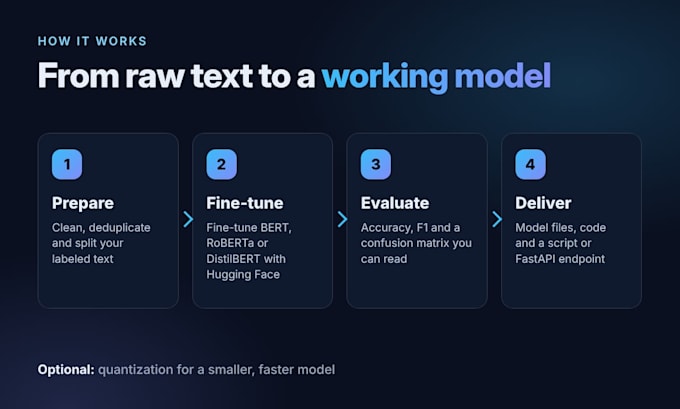
Um arquivo CSV ou Excel com seu texto e rótulos funciona melhor. Não tem rótulos ainda? Posso sugerir um plano de rotulagem ou usar métodos zero-shot e baseados em LLM para te colocar em funcionamento.
Quais modelos você usa?
BERT, RoBERTa, DistilBERT ou MobileBERT, e LLMs open-source como Llama ou Mistral via Hugging Face. Escolho o menor modelo que atenda suas necessidades de precisão e velocidade.
Você pode garantir uma precisão específica?
Ninguém pode prometer precisão sem ver os dados. Eu deixo uma baseline no início, explico os resultados com clareza e melhoro o modelo nas revisões do seu pacote.
Vou conseguir rodar o modelo sozinho?
Sim. Você recebe os arquivos do modelo treinado, o código e um script simples de inferência. Opção padrão acrescenta um endpoint FastAPI, e a opção Premium adiciona Docker e implantação na nuvem.
Você trabalha com outros idiomas além do inglês?
Sim. Eu uso modelos multilíngues como XLM-RoBERTa e mBERT, incluindo hindi e outras línguas indianas.
Meus dados permanecem privados?
Seus dados são usados apenas para o seu projeto e nunca são compartilhados. Eu deleto minhas cópias após a entrega se você pedir.