Ver categorias
Explorar
Fiverr Pro
Português
$
USD
Tradução automática
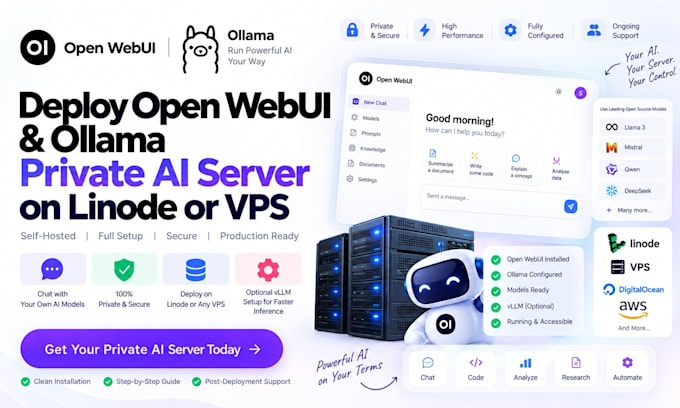
Implantar uma infraestrutura de IA privada hospedada por conta própria exige ajuste preciso do servidor e integração confiável de software para garantir inferência suave. Eu entrego configurações completas de Open WebUI, Ollama e motores vLLM de alto desempenho na Linode, DigitalOcean ou qualquer VPS dedicado, mantendo seus dados internos totalmente privados.
Minha pipeline de implantação cuida da preparação do sistema operacional, aceleração CUDA, orquestração de containers via Docker e entrega de interface web segura. Seja para modelos locais leves com Ollama ou processamento contínuo em lotes com baixa latência alimentado por vLLM, eu otimizo cada camada de acordo com as especificações do seu hardware.
Desde configurar criptografia SSL de domínio até gerenciar controles de acesso multiusuário, você recebe um centro de controle de IA pronto para produção, sob medida para equipes, desenvolvedores e empresas que exigem máxima capacidade de processamento e controle sobre seus LLMs privados.
AI Server Cloud Deployment Specialist
Idiomas
Tradução automática
Tradução automática
Por que devo usar vLLM ao invés do Ollama padrão para servir modelos?
Ollama é melhor para desenvolvimento simples de desktop e tarefas de usuário único, enquanto vLLM usa PagedAttention e processamento contínuo em lotes para oferecer maior throughput, baixa latência e gerenciamento eficiente de VRAM da GPU ao atender múltiplos usuários simultaneamente em produção.
Posso conectar APIs comerciais externas como OpenAI ou Anthropic junto com meus modelos locais vLLM?
Sim, o Open WebUI suporta nativamente conexões duplas. Você pode consultar modelos locais rodando via Ollama/vLLM e endpoints de API na nuvem ao mesmo tempo dentro do mesmo espaço de trabalho do usuário.
Quais especificações mínimas de hardware são necessárias para rodar vLLM e Open WebUI suavemente em um VPS?
Enquanto o Ollama apenas com CPU roda em instâncias padrão de VPS, rodar vLLM exige um VPS Linux equipado com uma GPU NVIDIA (pelo menos 16GB de VRAM para modelos de 7B/8B de parâmetros) e no mínimo 16GB de RAM do sistema para inferência ideal.
