Vou implantar e ajustar um llm privado auto-hospedado no seu próprio servidor GPU

S
stchopko
S
stchopko
Stepan C.
Algumas informações foram traduzidas automaticamente.

Sobre este Serviço

Tradução automática

Quer IA no estilo ChatGPT que rode no seu próprio hardware, sem enviar dados para terceiros? Vou configurar e deixar rápido.


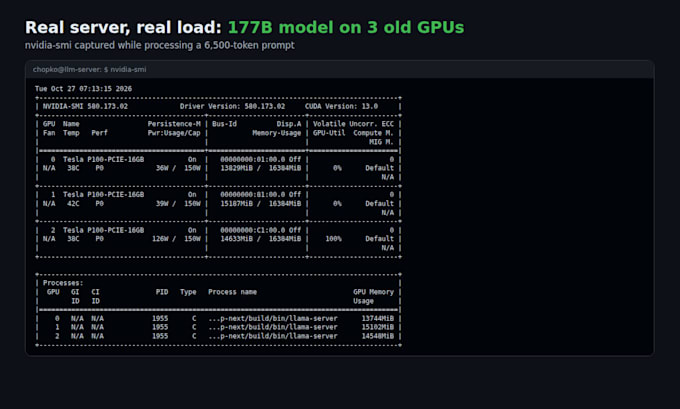
A maioria das configurações instala apenas um runner com as configurações padrão e deixa de fora entre 2 a 3x de desempenho. Eu faço benchmark e ajusto para o seu GPU e RAM exatos. Resultados reais do meu servidor (Tesla P100 16GB + EPYC):

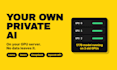
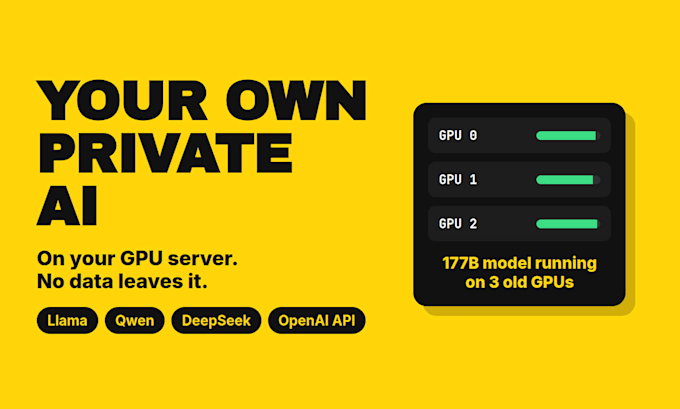
  • modelo MoE de 177B de parâmetros em três GPUs antigas de 16GB a 13,5 tokens/s
  • processamento de prompt 3,4x mais rápido (75 a 254 tokens/s) ajustando os tamanhos de batch
  • modelo de codificação de 80B a 30 tokens/s em duas GPUs antigas
  • a quantização certa para a geração de GPU

O que você recebe:

  • servidor llama.cpp com API compatível com OpenAI
  • interface de chat na web
  • seleção de modelo para o seu hardware e caso de uso
  • serviço de inicialização automática e acesso remoto seguro
  • relatório de benchmark: qual velocidade você obtém e por quê

Envie-me seu GPU, RAM e o que você quer que a IA faça, e eu te digo o que é realista antes de você fazer o pedido.

Conheça mais sobre Stepan C.

Stepan C.

PHP Developer and Self Hosted LLM Engineer

  • A partir deUcrânia
  • Membro desdemai. de 2021
  • Idiomas

    Ucraniano, Inglês
Backend developer with 9 years of commercial PHP (Symfony, Laravel, legacy code), including 6 years as Senior PHP Developer at an Irish software company, and hands-on experience running large language models on my own hardware. I fix and upgrade PHP sites that broke after a PHP 8.x update, migrate projects to modern Linux servers, and deploy private, self-hosted LLMs that run on your own GPU - no data leaves your server. I don't guess: I find the root cause, fix it, and tell you what was wrong. Clear written communication, fast replies.

Tradução automática