Ver categorias
Explorar
Fiverr Pro
Português
$
USD
Raspagem com Python, automação de dados, especialista em sites chineses
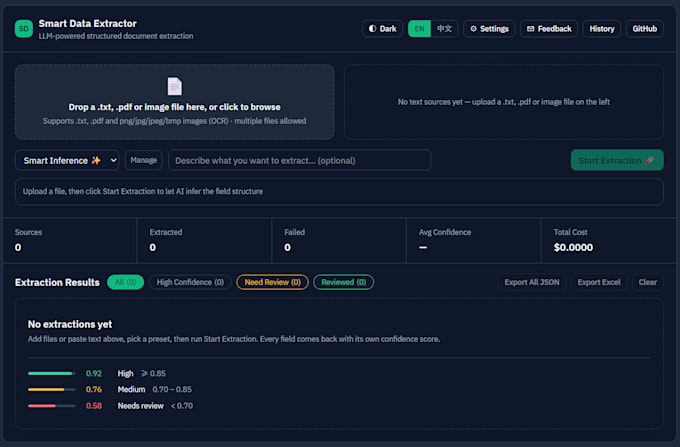
Precisa de uma ferramenta que transforme PDFs, documentos digitalizados, imagens ou texto colado em dados limpos e estruturados? Eu desenvolvo software personalizado de extração de dados com IA (Python, FastAPI, React) ao redor dos seus documentos e dos seus campos.
O QUE VOCÊ CONSEGUE
- Um pipeline de extração usando um LLM e OCR, feito sob medida para o seu esquema (faturas, cartões de visita, leads, formulários ou qualquer outra coisa)
- Validação de formato para campos de e-mail, telefone, URL e data
- Um score de confiança em cada campo. Valores ausentes ficam vazios e sinalizados, nunca inventados
- Exportação JSON/Excel, entregue como CLI, API REST ou app web, dependendo do seu pacote
- Código-fonte, testes automatizados e um README
POR QUE ESSA ABORDAGEM
Muitos demonstradores de extração com LLM parecem bons até verem que inventam um valor indiscriminadamente. Eu desenho para evitar isso: validação, sinais de confiança do motor OCR e uma tela de revisão para campos incertos. Não prometo 100% de precisão, mas campos errados ou ausentes são sinalizados em vez de passarem despercebidos.
Este gig se baseia em um projeto meu em funcionamento com mais de 700 testes automatizados. Documentos em inglês e chinês são suportados.
ANTES DE COBRAR
Envie-me 3-5 documentos de exemplo e os campos de que você precisa, para eu confirmar o escopo e o pacote certo.
Tecnologia:
Python
