Ver categorias
Explorar
Fiverr Pro
Português
$
USD

Tradução automática
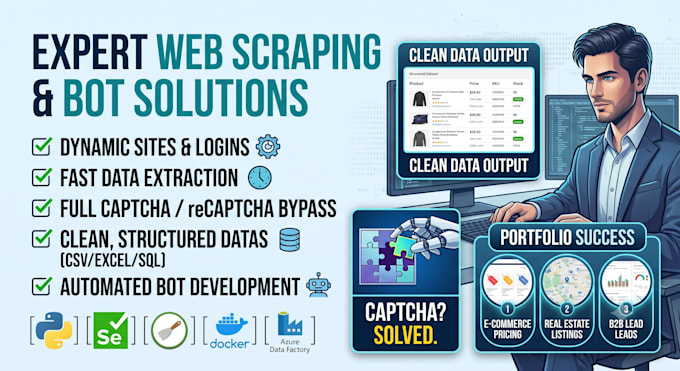
Precisa de um bot automatizado de web scraping em Python ou de uma extração de dados em grande escala? Eu crio scrapers resistentes, rápidos e escaláveis, feitos sob medida para suas necessidades exatas de dados.
Com mais de 5 anos de experiência em Engenharia de Dados, extraio dados de páginas estáticas, sites dinâmicos com JavaScript e portais protegidos por login, sem ser bloqueado.
O que eu ofereço:
Pilha de tecnologia:
Por que me escolher?
Nota: Por favor, envie uma mensagem com o URL do site alvo e os campos de dados necessários antes de fazer o pedido, assim posso testar o site e sugerir o melhor pacote!
Senior Data Engineer Web Scraping ETL Pipelines Azure Microsoft Fabric
Idiomas
Tradução automática
Tradução automática
O que você precisa de mim para começar?
Por favor, forneça o URL do site alvo, uma lista de campos/colunas específicos que você precisa (por exemplo, nome do produto, preço, avaliação, URL da imagem) e o formato de saída preferido (Excel, CSV, JSON ou SQL).
Você consegue fazer scraping de sites que exigem login ou usam JavaScript pesado?
Sim. Usando Selenium e Playwright, posso lidar com formulários de login, cookies, autenticações em várias etapas, pop-ups modais e feeds de scroll infinito.
Como você lida com CAPTCHAs e bloqueios do Cloudflare?
Integro APIs especializadas de resolução de CAPTCHAs de terceiros (como 2Captcha, CapSolver ou Anti-Captcha), junto com proxies residenciais rotativos e navegadores anti-detect como Playwright/Undetected-Chromedriver para contornar reCAPTCHA, hCaptcha e Cloudflare Turnstile automaticamente.
Você consegue automatizar o scraper para rodar diariamente ou semanalmente?
Sim! No pacote Premium, posso containerizar o script usando Docker ou configurar tarefas cron/ funções na nuvem (AWS Lambda ou Azure) para enviar os novos dados diretamente para Google Sheets ou seu banco de dados.