Ver categorias
Explorar
Fiverr Pro
Português
$
USD
Entusiasta de pesquisa
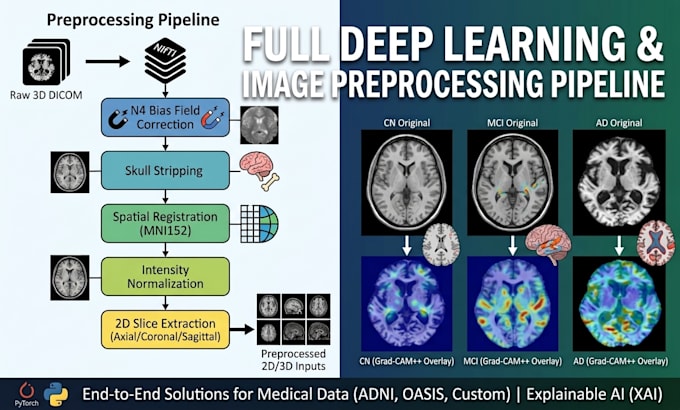
Precisa de um pipeline robusto de imagem médica, do scanner bruto até redes neurais treinadas?
Escaneamentos brutos (DICOM / NIfTI) não podem ser alimentados diretamente em modelos de deep learning sem alinhamento espacial adequado e normalização de intensidade. Eu crio pipelines completos de visão computacional médica, lidando com pré-processamento de dados, design de arquitetura personalizado e interpretabilidade do modelo.
1. Pré-processamento de Dados:
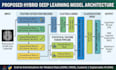
2. Deep Learning e Classificação:
3. IA Explicável (XAI):
Entregáveis:
Por favor, envie uma mensagem antes de fazer o pedido para discutir seu conjunto de dados e requisitos!
Tradução automática
Quais formatos de imagem médica você consegue lidar?
Posso processar formatos padrão de imagens médicas, incluindo DICOM (.dcm), NIfTI (.nii, .nii.gz), NRRD, além de formatos de imagem 2D (PNG, JPEG, TIFF). Seja seu conjunto de dados composto por escaneamentos volumétricos 3D ou conjuntos de fatias 2D extraídas, posso criar um pipeline automatizado para lidar com isso.
Seu pipeline inclui pré-processamento como remoção de crânio ou correção de viés?
Sim. Escaneamentos médicos brutos precisam ser padronizados antes de serem alimentados em modelos de deep learning. Meu fluxo de trabalho de pré-processamento cobre conversão de DICOM para NIfTI, reorientação espacial (alinhamento RAS), correção do campo de viés N4, remoção de crânio/extracção cerebral, registro MNI152 e normalização de intensidade.
Quais frameworks e bibliotecas de deep learning você usa?
Principalmente construo pipelines modulares e reprodutíveis em Python usando PyTorch, OpenCV, SimpleITK, NiBabel, NumPy e scikit-learn. Se precisar especificamente de TensorFlow ou Keras, posso adaptar a arquitetura do modelo ao seu framework preferido mediante solicitação.
Como você lida com desequilíbrio de classes em conjuntos de dados médicos?
Classes desequilibradas (por exemplo, menos amostras de doenças do que controles normais) podem enviesar severamente os modelos de deep learning. Eu mitigo isso usando estratégias técnicas como Amostragem Aleatória Ponderada durante a criação do carregador de batch, funções de perda de entropia cruzada ponderada por classe e técnicas de aumento de dados para equilibrar as classes.
O que é IA Explicável (Grad-CAM++) e por que eu preciso dela?
Redes neurais profundas costumam ser criticadas por serem "caixas pretas." Grad-CAM++ gera mapas de calor de ativação de classe diretamente sobre seus escaneamentos MRI/CT para destacar visualmente as regiões cerebrais ou anatômicas exatas (como atrofia de tecido ou ventrículos aumentados) que impulsionam a previsão do modelo. Essa interpretabilidade ajuda a entender as decisões do modelo.
Você fornece diagnóstico médico ou avaliação clínica de pacientes?
Não. Em total conformidade com as diretrizes do Fiverr, não forneço serviços de diagnóstico clínico, consulta a pacientes ou aconselhamento médico. Meus serviços se limitam a engenharia de software, pré-processamento de dados, arquitetura de modelos de machine learning e assistência técnica acadêmica/de P&D.
Quais entregáveis receberei ao finalizar o pedido?
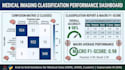
Dependendo do pacote escolhido, você receberá código fonte modular, limpo em Python (ou Notebooks Jupyter), arquivos de peso do modelo treinado (.pt ou .h5), scripts de pré-processamento de dataset, saídas de avaliação visual (Matriz de Confusão, Curvas de Perda/Acurácia, curvas ROC) e mapas de calor Grad-CAM++.
Podemos assinar um NDA ou garantir que meu conjunto de dados de pesquisa proprietário permaneça confidencial?
Com certeza. Levo a privacidade dos dados a sério. Seu conjunto de dados e o código do projeto permanecerão 100% confidenciais e nunca serão compartilhados, publicados ou reutilizados de qualquer forma. Estou totalmente aberto a assinar um Acordo de Confidencialidade (NDA) antes de você enviar os arquivos.