Ver categorias
Português
$
USD
Conecte-se à sua IA
Tradução automática
Faça o trabalho rotineiro de documentos e pastas mais fácil de repetir.
Vou criar um fluxo local em Python para extrair o texto existente de PDFs digitais, fazer inventário de um diretório, identificar conteúdo idêntico ou criar uma cópia de pastas organizada usando regras acordadas.
Os outputs podem incluir um TXT por documento, JSON em nível de página, um CSV de status e um inventário com caminhos relativos, tamanhos e fingerprints SHA-256. Páginas em branco ou aquelas sem conteúdo extraível são sinalizadas.
O organizador cria um plano revisável primeiro. O modo de cópia explícita preserva os originais e verifica os resultados. Não move nem exclui seu material de origem.
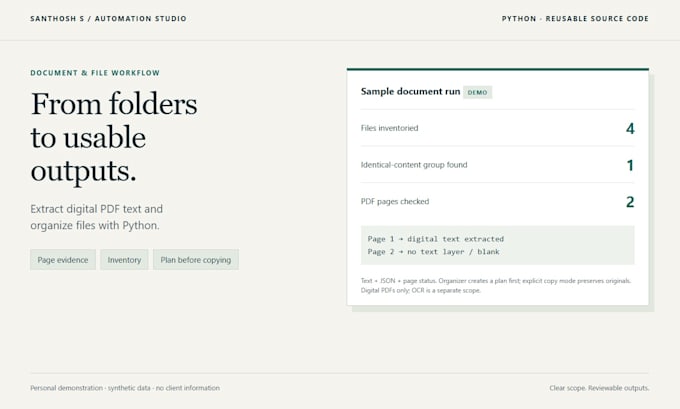
Você recebe código reutilizável, instruções de execução, amostras de saída e um resumo. Minha demonstração pessoal usa dados sintéticos: quatro itens inventariados e uma amostra de duas páginas verificadas, incluindo uma página em branco.
Digitalizações, OCR, escrita à mão, reconstrução de tabelas, documentos com trava e web scraping precisam de escopo separado. A ordem de leitura depende da estrutura original.
O Premium inclui um guia de configuração do Windows e 14 dias de correção de defeitos no escopo entregue.
Envie uma amostra sanitizada, contagens, tamanho total e saída desejada antes de escolher um pacote.
Senior Executive
Idiomas
Tradução automática
Tradução automática
Você pode processar PDFs digitalizados ou imagens?
Este pacote cobre PDFs digitais com uma camada de texto existente. Digitalizações e escrita à mão precisam de um fluxo OCR com escopo separado. Páginas sem texto são sinalizadas em vez de adivinhadas.
Tabelas e o layout original do PDF serão preservados?
Não. A saída é texto extraído com evidência de página. A ordem de leitura do PDF varia, e reconstrução de tabelas ou preservação do layout exigem um escopo separado baseado em amostras.
O organizador vai mover ou excluir meus arquivos?
Não. A execução padrão produz um plano. Uma execução explícita de cópia cria cópias organizadas e verifica os hashes de conteúdo; os originais são preservados. Conteúdo duplicado é relatado apenas.
Posso rodar a automação novamente?
Sim. O código-fonte em Python e um guia de execução estão incluídos. As entradas devem manter a estrutura acordada, e cada execução escreve em uma pasta de saída nova ou vazia.
Quais regras de organização estão incluídas?
O Premium cobre agrupamento por extensão ou mês UTC modificado, mantendo a estrutura original de pastas relativas. Classificação específica de negócios ou extração de campos de PDF é scope separado.
Quais arquivos eu devo compartilhar?
Envie uma amostra representativa sanitizada e as contagens primeiro. Forneça cópias de PDFs desbloqueadas. Não envie senhas ou dados pessoais desnecessários. Confirmamos o escopo antes de processar o lote completo.
Quais são os limites de arquivo, página e tamanho?
Básico: 20 PDFs / 100 páginas / 50 MB. Padrão: 100 PDFs / 500 páginas / 200 MB + 1.000 arquivos de inventário. Premium: 200 PDFs / 1.000 páginas / 300 MB + 5.000 arquivos de inventário e até 2 GB de cópias. Tanto o número de PDFs quanto os limites de páginas combinadas se aplicam.
