Ver categorias
Português
$
USD
Conecte-se à sua IA
Engenheiro de dados
Procurando um engenheiro de dados Databricks experiente para construir um pipeline de dados confiável e escalável? Sou Certified Databricks Data Engineer com mais de 5 anos de experiência em criar pipelines ETL em grande escala usando PySpark, Spark SQL e Delta Lake para clientes globais nos setores financeiro e de saúde.
O que eu entrego:
Por que trabalhar comigo:
Tenho mais de 3 fontes ou requisitos personalizados e eu envio uma oferta sob medida.
Tradução automática
Qual plataforma de cloud você suporta?
Eu me especializo em Azure Databricks, incluindo armazenamento ADLS Gen2 e Azure Data Factory.
E se eu tiver mais de 3 fontes de dados?
Manda mensagem antes de pedir, com seus requisitos, que eu mando uma oferta personalizada.
O que receberei no final?
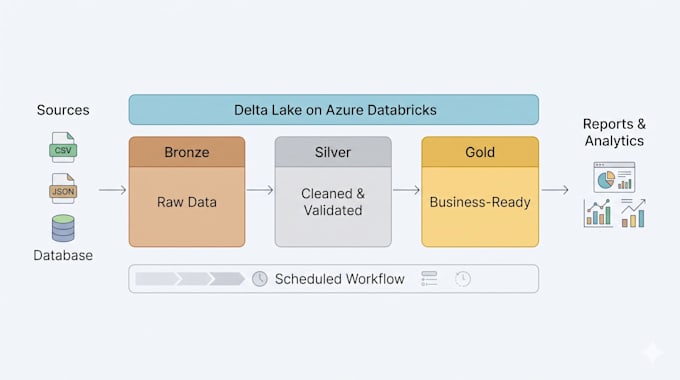
Notebooks PySpark/Spark SQL, um Databricks Workflow agendado, um diagrama de arquitetura e documentação explicando como rodar e manter o pipeline.
Você consegue trabalhar com o formato de dados que eu já tenho?
Sim. Consigo ingerir CSV, JSON, Parquet, Delta e tabelas de banco de dados. Compartilha um exemplo antes de pedir se o seu formato for incomum.