Ver categorias
Explorar
Fiverr Pro
Português
$
USD
Engenheiro de dados empresarial criando pipelines automatizados e otimizando SQL
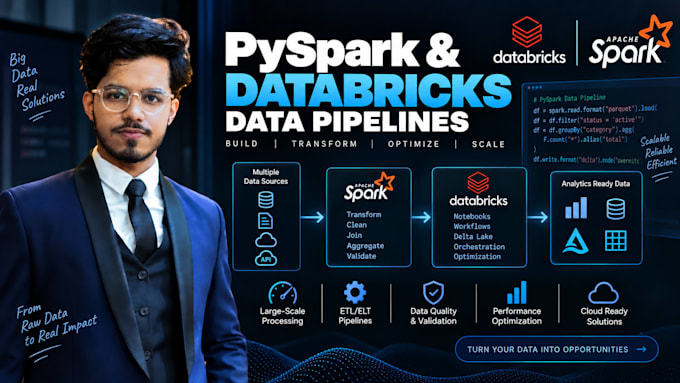
Precisa de ajuda para processar grandes conjuntos de dados com PySpark ou Databricks?
Vou criar pipelines de dados escaláveis usando PySpark, Apache Spark e Databricks para transformação, processamento e análise de dados.
Posso ajudar com:
Foco em pipelines limpos, fáceis de manter e eficientes, com documentação clara.
Entre em contato comigo antes de fazer o pedido para projetos complexos, assim posso entender seus dados e requisitos.
Warehouse Platform:
Snowflake
•
Azure Synapse
•
Databricks
Tipo de projeto:
New Build
Tradução automática
Você trabalha com Databricks?
Sim. Posso criar notebooks, transformações, fluxos ETL e pipelines de processamento de dados no Databricks.
Você consegue processar grandes conjuntos de dados?
Sim. PySpark foi feito para processamento distribuído, e posso criar pipelines para grandes conjuntos de dados.
Você consegue otimizar um pipeline Spark já existente?
Sim. Posso investigar jobs lentos e otimizar transformações, joins, partições e cargas de trabalho no Spark.
Você consegue criar pipelines incrementais?
Sim. Posso implementar processamento incremental ou em batch, de acordo com suas necessidades e dados disponíveis.
Quais fontes de dados você pode usar?
Posso trabalhar com arquivos, APIs, bancos de dados, armazenamento na nuvem e data warehouses, dependendo do projeto.
Você consegue trabalhar com Snowflake ou outros warehouses?
Sim. Posso criar pipelines que transformam dados e os carregam em plataformas como Snowflake e outros warehouses suportados.
Você fornece documentação?
Sim. A documentação está incluída de acordo com o pacote selecionado.
Devo entrar em contato com você antes de fazer o pedido?
Sim, especialmente para projetos complexos. Compartilhe suas fontes de dados, transformações esperadas, destino e volume de dados aproximado.
