Ver categorias
Explorar
Fiverr Pro
Português
$
USD
Engenheiro de Dados sênior especializado em Cloud ETL e Arquitetura
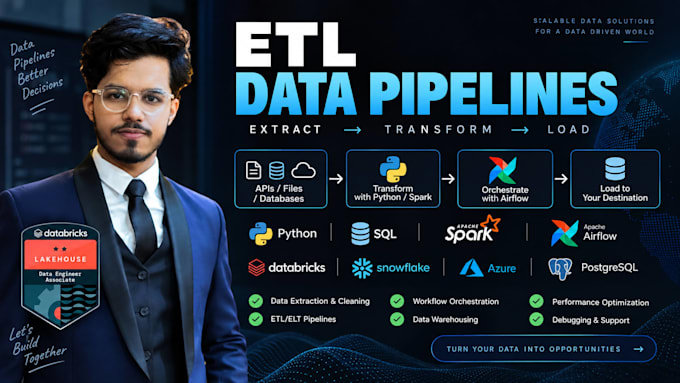
Precisa de um pipeline ETL confiável para automatizar seu fluxo de dados?
Vou criar um pipeline ETL/ELT limpo e escalável usando Python, SQL, Apache Spark/PySpark e Airflow.
Posso te ajudar com:
Você receberá código limpo, fácil de manter, documentação adequada e uma solução personalizada para suas necessidades.
Tem um pipeline existente que não está funcionando? Posso solucionar problemas e otimizá-lo também.
Ferramentas e plataformas:
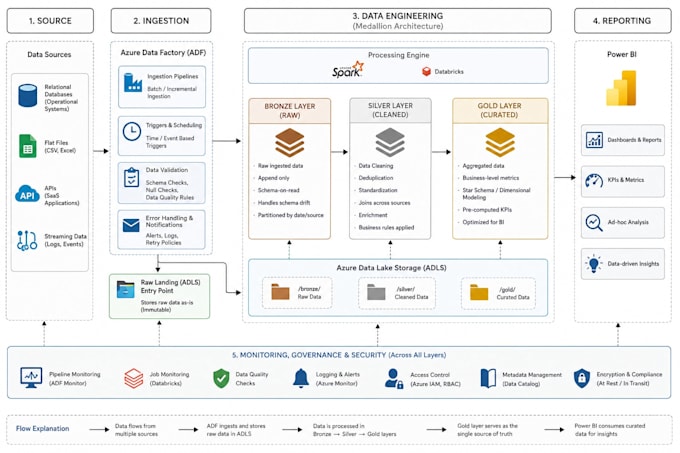
Fábrica de dados do Azure
Tradução automática
Com que tipos de fontes de dados você pode trabalhar?
Posso trabalhar com bancos de dados SQL, arquivos CSV/Excel, APIs REST, armazenamento na nuvem, dados JSON e muitas outras fontes de dados estruturados.
Você consegue criar workflows no Apache Airflow?
Sim. Posso criar DAGs no Airflow com agendamento, dependências, retries, logs e monitoramento.
Você suporta Apache Spark?
Sim. Eu construo pipelines de Spark para processamento de dados em grande escala, transformações e cargas ETL.
Você consegue automatizar tarefas recorrentes de dados?
Com certeza. Posso criar pipelines agendados que automaticamente extraem, transformam, validam e carregam dados.
Você consegue fazer a implantação do pipeline?
Sim. Assistência na implantação usando Docker ou plataformas na nuvem pode ser incluída como um Gig Extra ou no pacote Premium.