Ver categorias
Português
$
USD
Conecte-se à sua IA
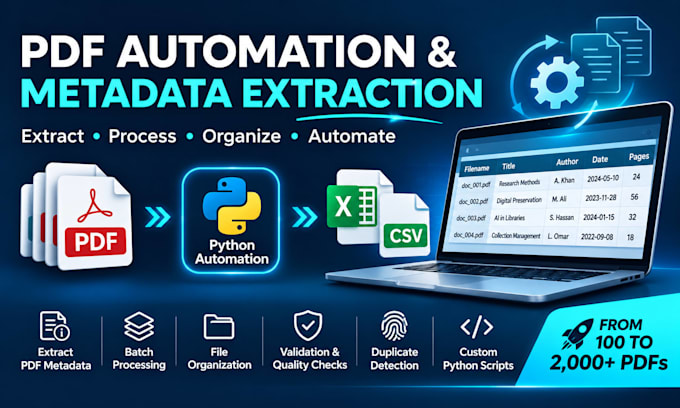
Precisa processar centenas ou milhares de arquivos PDF de forma eficiente?
Eu desenvolvo soluções de automação em Python para ajudar empresas, pesquisadores e indivíduos a extrair metadados, organizar documentos e automatizar tarefas repetitivas de processamento de PDFs.
Meus serviços incluem:
Por que escolher meu serviço?
Tenho experiência prática em desenvolver fluxos de trabalho de processamento de documentos e metadados em grande escala. Foco em soluções confiáveis testadas com documentação clara.
O que você vai receber:
Dependendo do seu pacote, você receberá relatórios estruturados de metadados, scripts Python reutilizáveis ou um fluxo de processamento de PDF personalizado.
Por favor, entre em contato comigo antes de comprar para discutir seus requisitos.
Observação: OCR, extração de texto de documentos digitalizados e layouts complexos exigem uma cotação personalizada.
Tecnologia:
Python
Especialidade:
Extração de dados
•
Manipulação de dados
Tradução automática
Você consegue processar centenas ou milhares de arquivos PDF?
Sim! Posso desenvolver fluxos de automação em Python para processar grandes coleções de PDFs. Meus pacotes cobrem até 100, 500 ou 2.000 arquivos, dependendo do pacote escolhido. Coleções maiores podem exigir uma cotação personalizada.
Quais informações você pode extrair de arquivos PDF?
Posso extrair metadados disponíveis como títulos de documentos, autores, datas de criação, datas de modificação, contagem de páginas, tamanho de arquivo e versões do PDF. A extração depende das informações incorporadas em cada documento.
Você consegue extrair texto de PDFs digitalizados?
Sim, a extração baseada em OCR pode ser discutida como um serviço personalizado. Pacotes padrão se concentram nos metadados embutidos no PDF e não incluem OCR ou reconhecimento de texto manuscrito.
Em quais formatos vou receber os dados extraídos?
CSV está incluso em todos os pacotes. Saída em Excel (.xlsx) ou JSON também pode ser fornecida quando acordado antes da compra. Scripts Python reutilizáveis estão incluídos nos pacotes Standard e Premium.
Você precisa de acesso ao meu computador ou servidor?
Nenhum acesso remoto normalmente é necessário. Eu posso desenvolver e testar a solução usando arquivos de amostra representativos. Você pode então rodar o script entregue no seu computador Windows ou Linux.
Como você lida com documentos confidenciais?
Recomendo compartilhar arquivos de amostra desidentificados ou não sensíveis sempre que possível. Eu uso os arquivos do projeto apenas para o trabalho acordado e não os compartilho com terceiros. Por favor, discuta qualquer requisito especial de confidencialidade ou manejo de dados antes de encomendar.
Você pode criar um fluxo de processamento de PDF personalizado?
Sim! Posso desenvolver fluxos de trabalho para extração de metadados, renomeação em lote, detecção de duplicatas, validação de arquivos e geração de relatórios estruturados. Entre em contato com seus requisitos para que eu possa avaliar o escopo e fornecer uma cotação adequada.
