Ver categorias
Português
$
USD
Conecte-se à sua IA


Tradução automática
Seu app de IA funciona na demonstração, mas dá problema com usuários reais: respostas erradas, alucinações, respostas lentas, contas surpreendentes na API. Eu vou descobrir o motivo e consertar.
Consertos comuns:
Funciona com LangChain, LlamaIndex, SDKs brutos do OpenAI/Claude, Vercel AI SDK, AWS Bedrock e n8n.
Por que me escolher: Como gerente de engenharia liderando iniciativas de IA, já implementei pipelines de RAG em produção e agentes de revisão de IA, e me preocupo com as partes menos glamourosas: avaliações, casos de falha e custo por solicitação.
Me envie uma mensagem com sua stack e 3-5 exemplos de saídas ruins.
Engineering Manager building production RAG and AI agents
Idiomas
Tradução automática
Tradução automática
Você precisa de acesso ao meu código?
O melhor é acesso de leitura ao repositório. Para o pacote de Auditoria, trechos de código mais uma sessão de compartilhamento de tela também funcionam.
Você vai reescrever tudo?
Não. Faço a menor mudança que resolve o problema e explico o porquê.
Como posso saber se realmente melhorou?
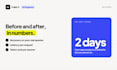
Os pacotes Standard e Premium incluem números antes/depois em um conjunto de testes: precisão, latência e custo por solicitação.


