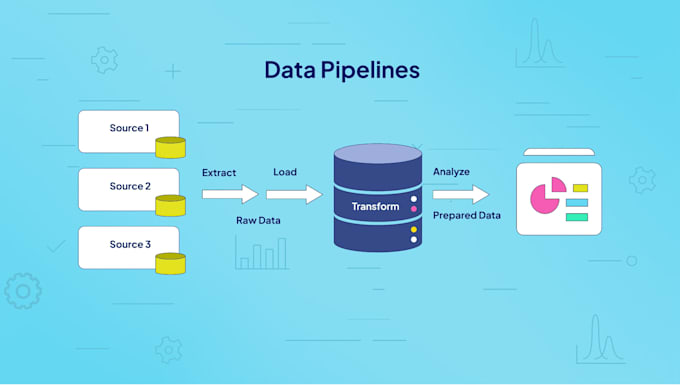
Sou um Engenheiro de Dados profissional com mais de 3 anos de experiência projetando e otimizando plataformas de dados de alta escala, processando mais de 400 TB diariamente. Seja para pipelines ETL de ponta a ponta, streaming em tempo real ou bancos de dados analíticos rápidos, construo sistemas de dados confiáveis e econômicos.
O que Posso Fazer Por Você:
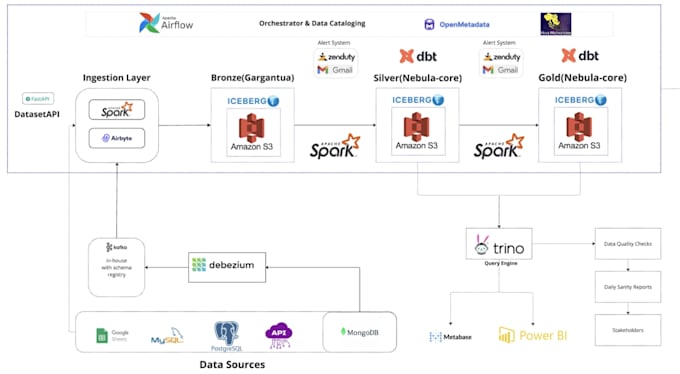
- Pipelines ETL & ELT: Projetar e automatizar pipelines em lote escaláveis usando Python, SQL, Apache Spark (PySpark) e Airflow.
- Lakehouse & Warehouse Moderno: Arquitetura e configuração com Apache Iceberg, Trino, ClickHouse, Redshift e PostgreSQL.
- Transformações & Modelagem: Camadas de ouro/prata robustas com dbt, modelagem de dados modular e testes.
- CDC em Tempo Real & Streaming: Integração com Kafka, Debezium CDC e ingestão ao vivo no ClickHouse.
- Otimização de Performance: Otimizar consultas SQL complexas, resolver gargalos e reduzir custos de infraestrutura.
Por que Trabalhar Comigo?
- Normas de engenharia testadas em produção
- Código escalável, limpo e totalmente documentado
- Comunicação clara e entrega no prazo
Por favor, envie uma mensagem antes de fazer seu pedido para discutir sua arquitetura e requisitos!