Ver categorias
Explorar
Fiverr Pro
Português
$
USD
Engenheiro de Dados na AWS, ETL, PySpark, AWS Glue, Airflow
Use todo o espaço de 1200 caracteres para tornar a palavra-chave do Gig rica em palavras, mas ainda assim legível:
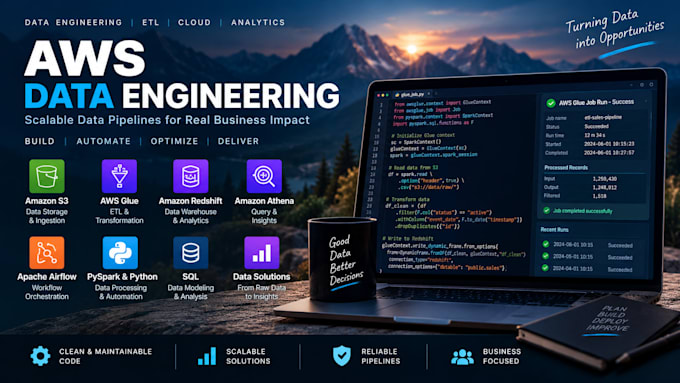
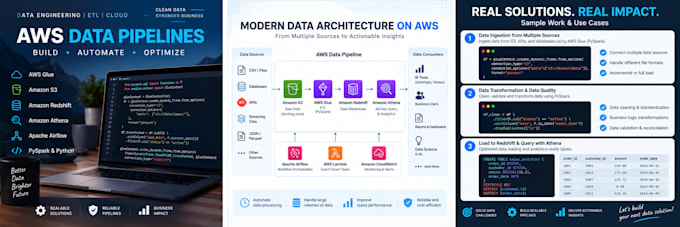
Vou criar pipelines de dados ETL confiáveis e escaláveis na AWS usando AWS Glue, PySpark, Python, Amazon S3, Amazon Redshift e outros serviços da AWS.
Posso ajudar você a desenvolver novos pipelines de dados, automatizar o processamento de dados, transformar conjuntos de dados ou solucionar problemas em fluxos de ETL existentes.
Meus serviços incluem:
Desenvolvimento de jobs ETL com AWS Glue
Transformações de dados com PySpark e Python
Ingestão e processamento de dados no S3
Processamento de dados em CSV, JSON e Parquet
Carregamento e transformação de dados no Redshift
Soluções Athena e Apache Iceberg
Validação e reconciliação de dados
Tratamento de erros e registro de pipelines
Otimização de desempenho de ETL
Migração de dados e automação
Foco em soluções limpas, fáceis de manter e prontas para produção, com validação adequada, tratamento de erros e documentação.
Se precisar de uma tarefa pequena de ETL ou de um pipeline completo de dados na AWS, posso desenvolver uma solução de acordo com suas necessidades.
Por favor, entre em contato antes de fazer o pedido para requisitos complexos ou multi-serviços, assim posso entender seu escopo e recomendar o pacote adequado.
Tecnologia:
Amazon Redshift
•
Excel
•
Python
•
SQL
•
NoSQL
•
Apache Airflow