Ver categorias
Explorar
Fiverr Pro
Português
$
USD

Tradução automática
Seus documentos já contêm as respostas. Eu crio o assistente de IA que encontra elas.
Desenvolvo apps de Retrieval-Augmented Generation (RAG) personalizados que permitem fazer perguntas em inglês simples e obter respostas fundamentadas nos seus próprios arquivos, com a citação exata da fonte por trás de cada uma.
Diferente de chatbots genéricos que inventam fatos com confiança, minhas criações são projetadas para evitar alucinações: cada resposta é retirada dos seus documentos, validada contra um esquema rigoroso, e a citação de apoio é checada programaticamente com o texto fonte. Alegações não verificáveis são sinalizadas, não falsificadas.
O que eu crio
Chatbots de Q&A sobre PDFs, relatórios, transcrições, contratos ou uma base de conhecimento
Extração estruturada de campos definidos de cada documento
Síntese entre documentos, temas comuns e divergências
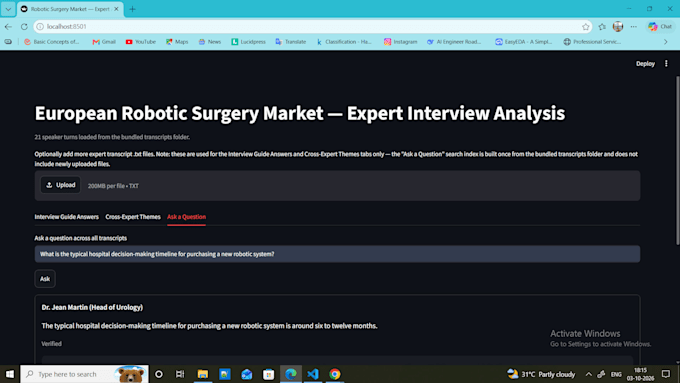
Uma interface limpa no Streamlit que sua equipe realmente pode usar
Pilha de tecnologia
LangChain, modelos Hugging Face & OpenAI, busca vetorial FAISS, embeddings sentence-transformer, saídas estruturadas Pydantic, Streamlit, Python.
Exemplo de construção
Veja o item do portfólio de um analisador de entrevistas que retorna citações verificadas com timestamps de transcrições de pesquisa de mercado.
Envie uma mensagem com seus documentos e as perguntas que precisa responder
AI Engineer, LLMs, RAG, MultiAgents Systems, Python, LangGraph, LangChain
Idiomas
Tradução automática
Tradução automática
Com que tipos de documentos você trabalha?
PDFs, arquivos Word, texto simples, transcrições, CSV e páginas web raspadas. Se puder compartilhar uma amostra, confirmarei se ela é limpa antes de você fazer o pedido.
Como você mantém as respostas precisas?
Cada resposta é gerada apenas a partir dos seus documentos (recuperação fundamentada, não da memória do modelo), limitada a um esquema de dados rigoroso, e a citação de apoio é checada com o texto fonte antes de ser exibida. Se não puder ser verificada, o app sinaliza ao invés de apresentar como fato.
Qual modelo de IA você usa?
Depende das suas necessidades. Costumo usar Meta Llama 3.1 via Hugging Face, e posso usar OpenAI ou um modelo local aberto se precisar de menor custo ou total privacidade. Vamos decidir juntos na primeira mensagem.
Eu recebo o código-fonte?
Sim — cada pacote inclui o código fonte completo e documentado e um guia de instalação. Sem lock-in.
Ele pode rodar de forma privada com meus próprios dados?
Sim. Para dados sensíveis, podemos rodar um modelo aberto hospedado por você, assim nada sai do seu ambiente.
Você consegue fazer a implantação pra mim?
Sim, como recurso Premium ou como extra no serviço. Você receberá um link funcional e a hospedagem configurada.
Quantos dados ele pode processar?
Ele escala de alguns poucos arquivos até milhares de documentos. Além de um corpus pequeno, eu persisto o índice vetorial no disco para que não precise ser reconstruído a cada execução.
O que você precisa de mim para começar?
Seus documentos (ou uma amostra representativa), de 3 a 5 perguntas de exemplo que deseja respostas, e quaisquer preferências de branding ou interface.
