Ver categorias
Português
$
USD
Conecte-se à sua IA
Web Scraping e dados de produto para Excel ou CSV
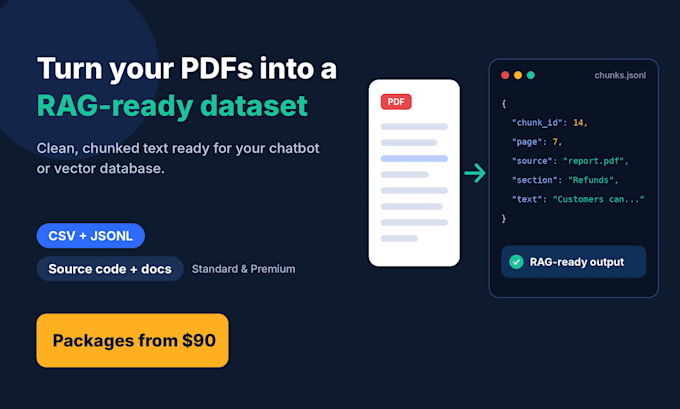
Precisa transformar seus PDFs em um conjunto de dados limpo, pronto para RAG? eu monto dados estruturados que você pode usar diretamente no seu pipeline de RAG, chatbot ou base de conhecimento.
O que você recebe:
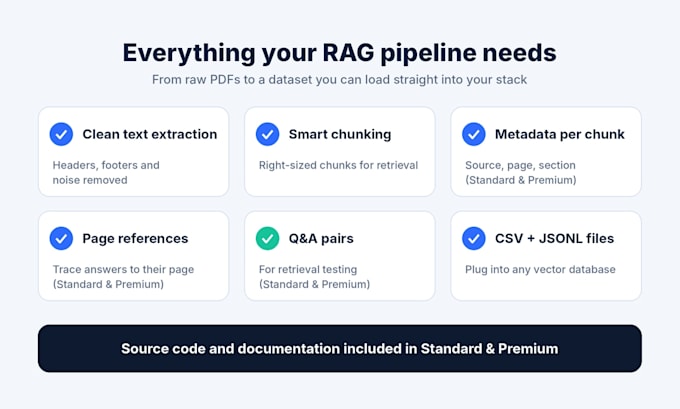
️ Extração de texto precisa (headings, rodapés e ruídos removidos)
️ Divisão inteligente com referências de página
️ Metadados para cada trecho (fonte, página, seção)
️ Pares de Q&A prontos para testes de recuperação e avaliação de LLM (Padrão e Premium)
️ Conjunto de dados JSONL + CSV, pronto para o seu pipeline de RAG e banco de vetores
️ Código-fonte e documentação (Padrão e Premium)
Como eu trabalho: confiro os resultados entre vários modelos e verifico manualmente amostras com base no seu texto de origem para reduzir alucinações. Trato seus arquivos de forma confidencial.
Perfeito para: startups de IA, criadores de chatbot, pesquisadores e desenvolvedores que estão montando uma base de conhecimento ou pipeline de RAG.
Comece pelo Basic para testar um PDF, depois aumente. Me envie uma mensagem antes de pedir com o tipo de PDF e a contagem de páginas!

Especialidade:
Outros
Frameworks:
Panda
Tipo de dados:
Texto
Linguagem de programação:
Python
•
SQL
Ferramentas:
Excel
•
Colab
APIs:
OpenAI
Tradução automática
Quais arquivos você aceita?
Apenas PDFs. Se o seu arquivo for Word, PPT ou uma imagem, me mande uma mensagem primeiro para eu confirmar se pode ser convertido.
Você trabalha com PDFs digitalizados?
PDFs baseados em texto funcionam melhor. PDFs escaneados precisam de OCR e podem exigir tempo extra ou uma oferta personalizada, então envie uma página de amostra antes de pedir.
O que vou receber?
Cada pacote oferece um conjunto de dados limpo CSV + JSONL com texto particionado. Padrão e Premium também incluem metadados, referências de página, pares Q&A, código-fonte e documentação.
Meus arquivos são confidenciais?
Sim. Eu não compartilho nem reutilizo seus arquivos com terceiros. Se seus documentos forem sensíveis, avise-me antes de pedir para eu confirmar como eles serão tratados.
Quantas páginas estão incluídas?
Básico: 1 PDF até 50 páginas. Padrão: 5 PDFs até 200 páginas. Premium: 15 PDFs até 600 páginas. Para mais, envie mensagem para uma oferta personalizada.
Posso testar com um PDF primeiro?
Sim, é exatamente para isso que o Basic serve. Teste um PDF, verifique a qualidade, depois aumente para Padrão ou Premium.