Ver categorias
Explorar
Fiverr Pro
Português
$
USD

Tradução automática
A maioria dos problemas com dados não são problemas de análise. São problemas de limpeza que ninguém quer encarar.
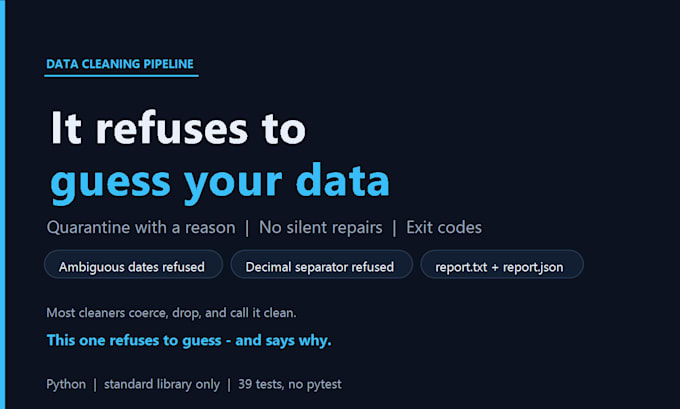
Um pipeline que "corrige" dados ruins silenciosamente é pior do que um que rejeita. Ele transforma 15/01/2026 no mês errado, elimina 3% das linhas e gera um relatório que parece limpo, mas está errado.
O QUE VOCÊ RECEBE
- Um pipeline em Python que lê seus arquivos, limpa o que consegue provar e coloca o restante em quarentena com uma justificativa escrita.
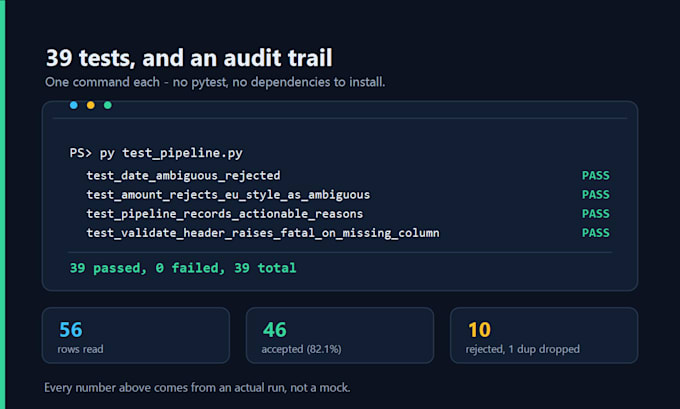
- Cada linha rejeitada vai para seu próprio arquivo com a fonte e o número da linha. Nada é eliminado silenciosamente.
- Regras de validação que você pode ler e alterar: tipos, intervalos, campos obrigatórios, formatos de data, duplicatas.
- Um relatório auditável mais códigos de saída, para que ele falhe alto ao invés de gerar um arquivo errado.
- Testes, para que você possa alterar as regras sem quebrá-las.
- Um documento de entrega: o que foi construído, como rodar, o que foi verificado e as limitações.
COMO EU FUNCIONO
Eu analiso seus dados antes de fazer o orçamento. Se uma coluna for ambígua, eu pergunto ao invés de adivinhar.
STACK
Python, apenas a biblioteca padrão. Nada para instalar.
Me diga o que "limpo" significa para seus dados e eu direi se é compatível. Amostras no GitHub - envie uma mensagem para o link.
all
Idiomas
Tradução automática
Tradução automática
Quais formatos de arquivo você consegue lidar?
Por padrão, CSV. Excel, TSV e textos de largura fixa também funcionam. Seu arquivo fonte nunca é modificado - o pipeline lê e escreve novos arquivos.
O que acontece com as linhas que não consigo limpar?
Elas vão para um arquivo separado de rejeitadas com o número da linha fonte e o motivo. Nada é eliminado silenciosamente, e o relatório conta elas para você ver exatamente o que foi excluído.
Você vai alterar meus dados originais?
Não. O pipeline só lê sua entrada. Cada saída é um arquivo novo, então sempre dá para comparar o resultado com a fonte.
Pode rodar em uma programação?
Sim. Ele sai com um código diferente de zero em caso de problema fatal, assim o cron ou o Task Scheduler podem identificar sucesso ou falha sem precisar ler o log.
Minhas colunas têm um significado específico para meu negócio.
Exatamente por isso eu pergunto antes de fazer o orçamento. Envie uma amostra e as regras de validação serão escritas nas suas definições, ao invés de serem adivinhadas pelos nomes das colunas.