Ver categorias
Explorar
Fiverr Pro
Português
$
USD
Engenheiro de dados
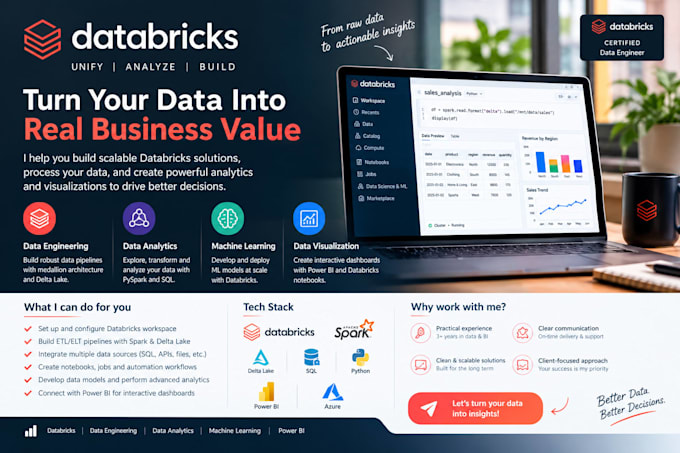
Transforme seus dados brutos em pipelines de dados confiáveis com Databricks!
Você está procurando ajuda com processamento de dados, pipelines ETL ou transformação de big data usando Databricks?
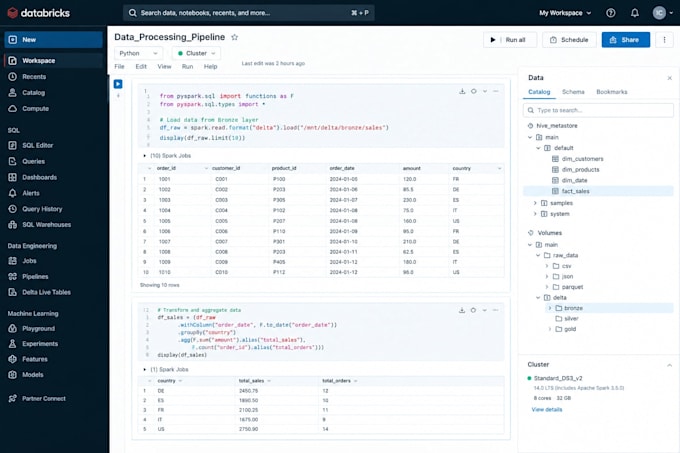
Posso ajudar a construir, otimizar e manter pipelines de dados usando Databricks, PySpark, Python, SQL e Delta Lake, adaptados às necessidades do seu projeto.
Com mais de 3 anos de experiência em análise de dados, desenvolvimento de ETL, transformação de dados e inteligência de negócios, entendo como transformar dados brutos em conjuntos de dados estruturados, confiáveis e prontos para análise.
Meus serviços de Databricks
1. Desenvolvimento em Databricks & PySpark
2. Pipelines ETL/ELT de dados
3. Delta Lake & Lakehouse
4. SQL & Otimização de dados
Tradução automática
Quais são suas fontes e formatos de dados de entrada?
Você já possui um workspace no Databricks?
O que você precisa para começar?
Por favor, forneça os requisitos do seu projeto, dados de amostra, saída esperada e detalhes sobre seu ambiente no Databricks.