Ver categorias
Português
$
USD
Conecte-se à sua IA


Tradução automática
Seus documentos contêm as respostas, mas encontrá-las leva muito tempo e um chatbot genérico vai inventar uma coisa.
Eu crio assistentes que respondem apenas a partir dos seus arquivos e mostram a página exata, a linha ou a URL por trás de cada resposta. Se a evidência não estiver nos seus documentos, eles avisam em vez de adivinhar.
Dois níveis, um sistema.
A construção de Document Q&A (Basic e Standard) é um app em Python para um conjunto pequeno de arquivos: PDF, CSV, TXT, Markdown ou páginas da web. Funciona no seu laptop, mostra as fontes em cada resposta e vem com um guia de configuração.
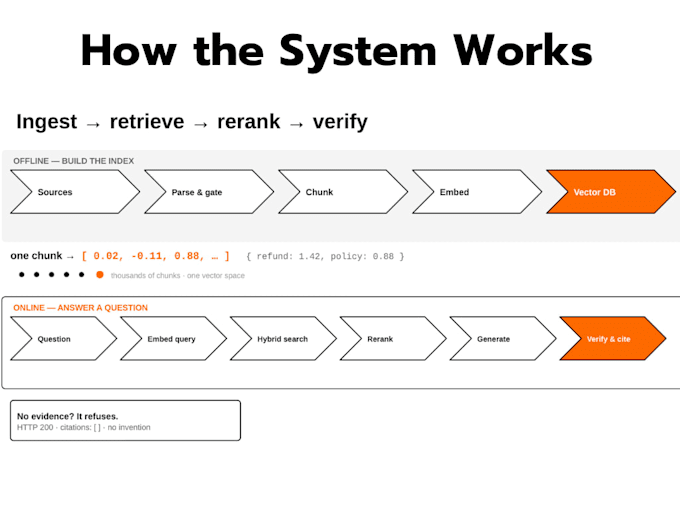
A construção ResearchOS (Premium) é para grandes corpora. Pesquisa híbrida que combina significado com termos exatos, uma etapa de reclassificação de LLM, chunking com sensibilidade a frases, um gate de qualidade de página que descarta páginas ilegíveis e citações validadas antes de você as ver. Ele é fornecido como FastAPI + PostgreSQL + Qdrant em Docker no seu servidor, com uma execução de avaliação nos seus próprios documentos.
Eu testo tudo com suas perguntas de exemplo antes da entrega.
Não incluído: OCR para PDFs digitalizados, SaaS multi-tenant, treinamento de modelo personalizado, aconselhamento jurídico ou médico
AI Engineer, RAG, LLM Apps and Automation
Idiomas
Tradução automática
Tradução automática
Ele consegue ler PDFs digitalizados?
Sem OCR. Páginas sem camada de texto retornam vazio em vez de adivinhar. Na versão Premium, o gate de qualidade as elimina explicitamente e informa quantas páginas foram puladas. Se a digitalização for apenas imagem, me avise antes de pedir que eu te digo claramente se funciona.
Qual a diferença entre Standard e Premium?
Standard é um app local leve para alguns arquivos. Premium é um sistema implantável para um corpus maior: pesquisa híbrida, reclassificação, backend PostgreSQL + Qdrant, Docker e um relatório de avaliação mensurado. Se não tiver certeza, envie a contagem de páginas e eu te indico o tier certo.
Ele vai inventar respostas?
Foi feito para recusar. Quando a recuperação não encontra evidência, ele retorna uma lista de fontes vazia em vez de gerar. No Premium, os números de citação são validados com o que foi realmente recuperado, então referências fabricadas são removidas antes de você ver a resposta.
Quão precisa ela é?
Eu testo e reporto. Em um corpus de 296 páginas de teste: recall@10 1.00, nDCG@10 0.72, precisão de citações 0.59, e toda resposta fundamentada em pelo menos uma fonte. É uma base de avaliação pequena e manual, não um benchmark — e quem promete 100% de precisão de citações está chutando.
Meus dados são enviados para algum lugar?
As embeddings e as respostas vão para OpenAI ou Gemini usando sua chave. Seus documentos, trechos e vetores permanecem na sua máquina ou servidor — PostgreSQL e Qdrant no Premium rodam localmente.
Eu preciso de um servidor?
Basic e Standard: não, é no seu laptop. Premium: Docker com PostgreSQL e Qdrant; incluo o arquivo compose e as notas de implantação.