Ver categorias
Explorar
Fiverr Pro
Português
$
USD
Engenheiro de IA: Agentes LLM, RAG, Document AI, Visão Computacional e Análise de Vídeo
Nível 1
Atendeu a determinados critérios de desempenho e demonstra forte potencial no marketplace.
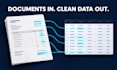
Ainda pagando alguém para digitar dados de faturas, recibos, IDs ou formulários manualmente?
Eu crio sistemas de OCR e Document AI que leem seus documentos e retornam dados limpos e estruturados direto na sua planilha, banco de dados ou aplicativo.
O QUE EU EXTRAI
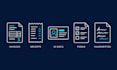
- Faturas e recibos: itens, totais, datas, impostos, detalhes do fornecedor
- Documentos de ID e KYC: passaportes, carteiras de motorista, IDs nacionais
- Contratos e formulários: cláusulas, campos, assinaturas, caixas de seleção
- Documentos manuscritos e digitalizados, incluindo scans de baixa qualidade
- Tabelas, mesmo quando atravessam várias páginas
Cada pipeline inclui regras de validação que detectam erros antes de chegar até você, saída em JSON, CSV ou Excel estruturado, e um relatório de precisão para você saber como ele funciona nos seus documentos, não em uma demonstração.
STACK: Python, PaddleOCR, Tesseract, AWS Textract, Google Document AI, Azure Document Intelligence, GPT-4 Vision.
Comece com a Prova de Conceito. Envie de 3 a 5 documentos reais e eu mostrarei a extração rodando nos SEUS dados, com um relatório de precisão, antes de você se comprometer com uma implementação completa.
Me envie 2-3 exemplos e os campos que você precisa, e eu direi honestamente o que é possível.

Tecnologia:
Excel
•
Planilhas Google
•
Python
•
Zapier
•
Outros
Tradução automática
Isso vai funcionar com meus documentos específicos?
Exatamente para isso serve o pacote de Prova de Conceito. Envie 3-5 documentos reais e eu farei a extração e mostrarei os resultados com um relatório de precisão antes de você se comprometer com algo maior. Se seus documentos não forem compatíveis, você paga uma pequena quantia e descobre.
Qual precisão posso esperar?
Depende dos seus documentos, e quem te passar um valor antes de ver eles está chutando. PDFs digitais limpos com layouts consistentes geralmente alcançam alta precisão. Scans ruins, escrita manual e layouts muito variáveis são mais difíceis. Por isso, todo pacote inclui um relatório de precisão que mede isso.
Eu recebo o código fonte e uma API funcionando?
Sim, desde o pacote Standard em diante. Você recebe o código fonte completo, e o pacote Premium inclui uma API mais implantação no seu servidor, com Docker, e documentação para sua equipe manter sem minha ajuda.
Meus documentos são confidenciais. Meu dado está seguro?
Sim, e vou ser bem claro. Preciso apenas de exemplos, e você pode esconder informações sensíveis antes de enviar. Se seus documentos não puderem ser processados por um serviço de terceiros, posso montar toda a pipeline usando OCR open-source hospedado na sua infraestrutura, sem nada sair dela.
Você consegue lidar com texto manuscrito ou scans de baixa qualidade?
Frequentemente sim, mas honestamente varia mais do que texto impresso. Escrita manual, scans desbotados, fotos inclinadas e fax de baixa resolução reduzem a precisão, e o quanto depende dos seus documentos específicos. Pré-processar ajuda bastante. Envie exemplos dos piores documentos no Proof of Concept e eu avalio.
Qual formato de saída eu recebo?
O que melhor se encaixar no seu fluxo de trabalho: JSON estruturado, CSV, Excel ou direto no seu banco de dados ou app via API. Me diga onde os dados precisam chegar e entregarei nesse formato, sem precisar que você converta o arquivo sozinho.


