Ver categorias
Explorar
Fiverr Pro
Português
$
USD

Tradução automática
Precisa de um sistema de IA personalizado, não apenas uma camada em uma API? Eu planejo, construo do zero e entrego o código para você.
Muhammad Omaid, chefe de IA na Magnus Mage (fundada em 2019): mais de 8 anos em produção, mais de 10 engenheiros, 4 sistemas de IA ativos.
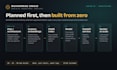
Os primeiros 5 a 10 dias são de planejamento: arquitetura, seleção de bibliotecas, um plano escrito que você aprova antes do código.
O que construímos do zero:
RAG: embeddings personalizados, codificação e decodificação ajustadas, FAISS ou pgvector, recuperação agrupada em 3D para ajustar chunking e recall.
Pós-treinamento: SFT, DPO, QLoRA em Llama, Qwen ou Mistral, com relatórios de avaliação; inferência privada nos seus GPUs.
Multi-LLM: roteamento entre modelos abertos e hospedados por custo, latência e sensibilidade de dados.
Serviços FastAPI com esquemas Pydantic, trabalhadores assíncronos e contratos OpenAPI.
Contêineres Docker empresariais para alto tráfego: testados, monitorados, na AWS, Kubernetes ou localmente.
Segurança: autenticação, limites de taxa, log de auditoria.
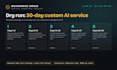
Pacotes: MVP em 30 dias, Avançado em 45; Enterprise é uma equipe dedicada por $10.000 por mês.
Você recebe código fonte, documento de arquitetura, relatórios de carga, avaliações, CI/CD, vídeo de walkthrough, janela de correção de bugs.
Envie uma mensagem antes de pedir, com seu caso de uso, dados e tráfego para uma cotação personalizada.
Head of AI at Magnus Mage, LLM RAG and fine tuned models
Idiomas
Tradução automática
Tradução automática
O que acontece na fase de planejamento?
Dias 1-5 (MVP) ou 1-10 (Avançado): mapeamos seu caso de uso, dados e tráfego, escolhemos a arquitetura e bibliotecas (FastAPI, FAISS ou pgvector, Transformers, Docker, Kubernetes) e escrevemos um plano com marcos. Você aprova antes de qualquer código ser escrito.
O que significa RAG construído do zero?
Sem templates de frameworks. Treinamos ou ajustamos embeddings personalizados, ajustamos codificação e decodificação para seus documentos, indexamos no FAISS ou pgvector e agrupamos o espaço de recuperação em 3D para ajustar o tamanho do chunk e o recall. Você recebe métricas de recuperação, não apenas um chatbot.
O que é pós-treinamento e quando preciso dele?
Pós-treinamento adapta um modelo aberto (Llama, Qwen, Mistral) aos seus dados com SFT, DPO ou QLoRA. Você precisa quando prompts e RAG não são suficientes: linguagem de domínio, formatos de saída rigorosos, chamadas de ferramentas. Incluído no Avançado e no Enterprise, com relatório de avaliação antes e depois.
O que é roteamento multi-LLM?
Uma API, vários modelos. As solicitações são roteadas por custo, latência e sensibilidade de dados: dados sensíveis permanecem no seu modelo privado, tarefas gerais vão para um modelo hospedado, com fallback e rastreamento de custo por chamada. Incluído no Avançado e no Enterprise.
Por que FastAPI e Pydantic?
FastAPI oferece serviços assíncronos de alta taxa de transferência com contratos OpenAPI integrados; esquemas Pydantic validam cada solicitação e resposta para que a camada de IA nunca receba ou retorne dados malformados. Ambos são escritos do zero para seu sistema, sem geradores de boilerplate.
Como você lida com alto tráfego?
Contêineres Docker empresariais com trabalhadores assíncronos e filas, escalabilidade horizontal no Kubernetes ou AWS, cache, limites de taxa e teste de carga com seu tráfego alvo antes da entrega. Monitoramento e alertas estão incluídos no Avançado e no Enterprise.
Pode rodar na minha infraestrutura própria?
Sim. Tudo é enviado como contêineres Docker e roda na sua nuvem (AWS, GCP, Azure), Kubernetes ou GPUs locais. Para inferência privada, servimos modelos abertos com vLLM ou Ollama, assim seus dados nunca deixam sua rede.
MVP, Avançado ou Enterprise: qual escolher?
MVP (30 dias): um serviço de IA com RAG, FastAPI e Docker. Avançado (45 dias): MVP mais um modelo pós-treinado, roteamento multi-LLM, clusters de recuperação 3D e monitoramento. Enterprise: uma equipe dedicada por $10.000 por mês, mínimo de dois meses, renovável enquanto precisar.
O que recebo ao final?
Código fonte no seu repositório, documento de arquitetura, relatórios de carga, avaliações, pipeline CI/CD, imagens Docker, vídeo de walkthrough e janela de correção de bugs. Você possui o código, os pesos do modelo e os dados.
Como trabalhamos juntos?
Envie uma mensagem antes de pedir, com seu caso de uso, dados e tráfego; responderemos com um plano e uma cotação personalizada. Durante a construção: atualizações diárias no Fiverr, marcos, demonstração ao final de cada fase. NDA sob solicitação.


