Ver categorias
Explorar
Fiverr Pro
Português
$
USD

Level 1
Tradução automática
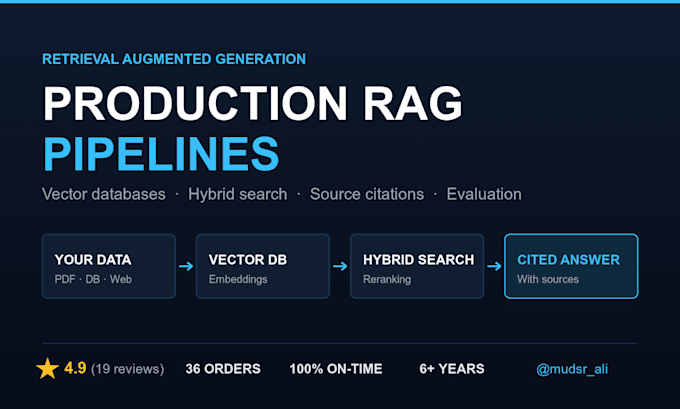
Precisa de um chatbot RAG ou pipeline de recuperação que faça mais do que simplesmente enviar documentos para um LLM?
Eu crio sistemas personalizados de Geração Aumentada por Recuperação (RAG) que buscam informações relevantes nos seus dados e usam isso para gerar respostas contextuais.
O que posso construir:
Pilha de tecnologia: Python, FastAPI, LangChain ou LlamaIndex quando apropriado, PostgreSQL/pgvector, Qdrant, Chroma e outros armazenamentos de vetores compatíveis.
Posso ajudar você a criar um novo pipeline RAG, melhorar uma implementação existente ou integrar recuperação na sua aplicação.
Cada projeto tem dados, requisitos de qualidade e restrições de infraestrutura diferentes. Por favor, envie uma mensagem com seu caso de uso, fontes de dados e resultado esperado antes de fazer o pedido, assim podemos definir o escopo adequado.
Senior Software Engineer, SaaS, Backend, Cloud, Ai
Level 1
Idiomas
Tradução automática
Tradução automática
Qual pacote se encaixa no meu projeto?
Diga-me aproximadamente quanto conteúdo você tem e onde ele está. O pacote inicial é para uma única fonte com menos de 500 páginas. O pacote de produção é para um corpo completo onde a precisão das respostas importa. O pacote plataforma é para múltiplos sistemas que estão mudando constantemente.
Qual banco de dados vetorial você usa?
Qualquer um que se encaixe no seu caso: Pinecone, Qdrant, Weaviate, Chroma ou pgvector. Se você já usa PostgreSQL, o pgvector muitas vezes evita um serviço novo e custo adicional. Recomendo com base na escala e no orçamento, não na preferência.
Quão precisas serão as respostas?
Não prometo um número antes de ver seus dados. O que prometo é medição: os pacotes Standard e Premium incluem um conjunto de avaliação para você ver a precisão da recuperação como um número, e cada resposta vem com citações para que saídas incorretas possam ser rastreadas.
Quem paga pelo uso da API da OpenAI ou Claude?
Você faz isso, na sua própria conta, assim mantém controle e total visibilidade dos gastos. Os custos de embedding e consulta são os principais fatores. Estimo seu custo mensal realista antes de começarmos e incluo cache e limites de tokens para manter o valor baixo.
Meus dados permanecem privados?
Tudo roda na sua própria infraestrutura e contas de provedores. Uso endpoints de API que não treinam seus dados, e assinarei um NDA. Se seus documentos não puderem sair dos seus servidores, posso construir uma solução totalmente auto-hospedada com modelos abertos.
O que você precisa de mim para começar?
Uma amostra dos seus documentos ou acesso ao banco de dados, de 10 a 20 perguntas de exemplo que os usuários farão, e sua chave de API do provedor. As perguntas de exemplo são as mais importantes: elas se tornam o conjunto de avaliação contra o qual ajusto a recuperação.
