Ver categorias
Explorar
Fiverr Pro
Português
$
USD
Transformando dados em soluções com precisão

Tradução automática
Como o Agentic ETL é diferente do ETL tradicional?
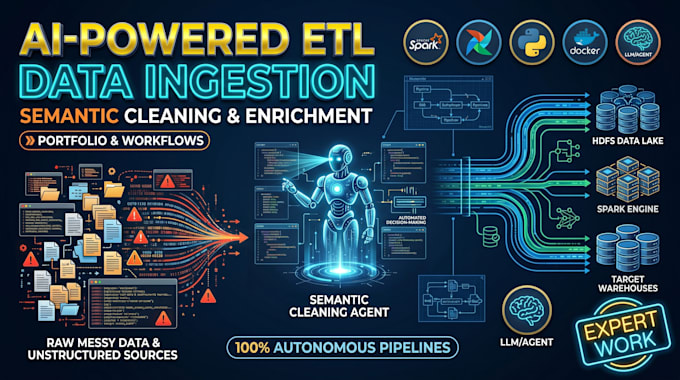
O ETL tradicional depende de regras rígidas e codificadas que quebram quando os formatos de dados mudam. Meus pipelines ETL agenticos usam IA para entender semanticamente, analisar e limpar dados não estruturados ou desorganizados antes de alimentá-los de forma segura no seu data lake HDFS, tornando o pipeline altamente resiliente.
Meus dados empresariais estão seguros ao usar esses agentes de IA?
Embora possamos integrar APIs comerciais, eu me especializo em implantar LLMs seguras e locais (como Qwen, DeepSeek, agentes baseados em frameworks) diretamente no seu ambiente containerizado. Assim, seus dados sensíveis nunca saem da sua rede ou cluster interno.
Preciso migrar minha infraestrutura atual?
Não. Eu projeto esses fluxos de trabalho agenticos para se integrarem perfeitamente com suas configurações atuais de Apache Airflow e Spark. Empacoto tudo usando Docker (ou Docker Swarm para alta disponibilidade) para que se conecte diretamente à sua arquitetura atual.
E se o agente não conseguir consertar uma falha?
Ele encaminha. Você recebe um alerta no Slack ou por e-mail com a causa raiz, as linhas de log relevantes e uma sugestão de correção. Mudanças arriscadas (código, esquema, qualquer coisa que toque nos dados de produção) sempre precisam da sua aprovação. O agente só corrige automaticamente os tipos de falha que combinamos que são seguros.
Você pode construir um novo pipeline ETL do zero, não apenas consertar um?
Sim. Eu projeto e construo pipelines de dados de ponta a ponta: ingestão de APIs, bancos de dados ou arquivos, transformação em PySpark ou Python, orquestração no Apache Airflow e carregamento no PostgreSQL, S3, Hive ou seu data warehouse.