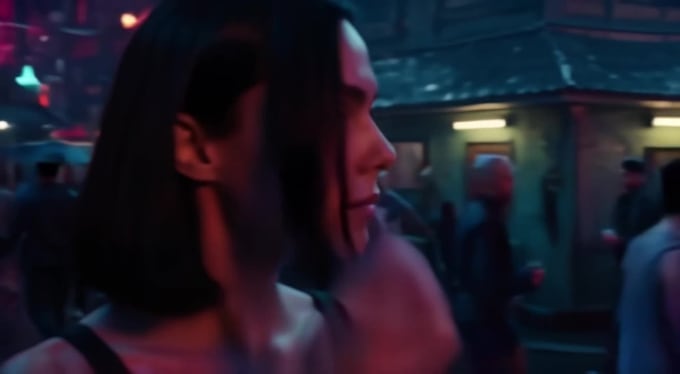Ver categorias
Explorar
Fiverr Pro
Português
$
USD

Tradução automática
Quer trazer seu personagem personalizado, IA influencer ou persona para a geração de vídeo LTX-2.5 com identidade facial consistente?
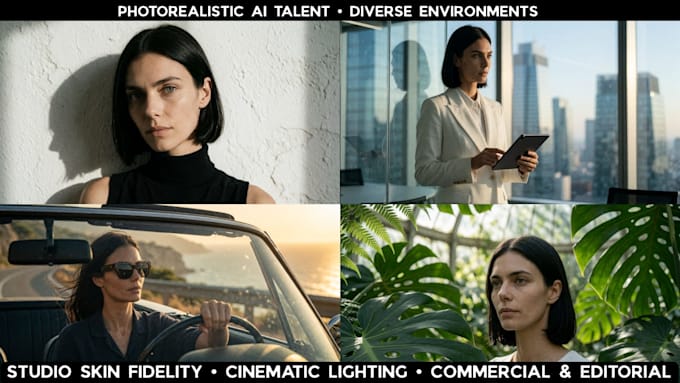
Eu treino LoRAs de personagem de alta precisão (.safetensors) desenvolvidos especificamente para o pipeline de vídeo LTX-2.5 no ComfyUI. Em vez de morphing facial aleatório, você recebe um modelo dedicado treinado nas suas imagens de referência para manter a semelhança entre iluminação, roupas e cenas.
O que você recebe:
LoRA de personagem personalizada para LTX-2.5 (.safetensors) treinada até 2.000 passos com legendagem limpa
Amostras de vídeo de 10 segundos com áudio ambiente nativo sincronizado (16:9 ou 9:16 vertical)
Guia de Prompt Testado: estrutura de prompt com marcação de tempo para ancorar a identidade facial e evitar distorção
Fluxo de trabalho JSON do ComfyUI (Premium / Gig Extra): configuração completa de nó em duas passadas com sigmas personalizados
Melhor para:
Influenciadores de IA virtuais e conteúdo para redes sociais (TikTok / Reels)
Personagens consistentes para trailers cinematográficos e storytelling
Tomadas de tracking controladas, retratos e coreografia
Faça seu pedido agora ou me mande uma mensagem para criar seu LoRA LTX-2.5 personalizado!
Informe o freelancer sobre suas preferências ou preocupações em relação ao uso de ferramentas de IA na conclusão e/ou entrega de seu pedido.
Create Stunning AI Characters High Quality LoRA Models
Idiomas
Tradução automática
Tradução automática
Quantas imagens eu preciso?
Básico aceita até 20 imagens, enquanto o Standard aceita até 50. Imagens claras com ângulos variados, expressões, enquadramento e iluminação costumam ser mais úteis do que muitas imagens quase idênticas.
Sua personagem vai parecer exatamente a mesma em todo vídeo?
Não é garantia de perfeição. O treinamento busca melhorar as características reconhecíveis da personagem, mas os resultados dependem do conjunto de dados, prompts, configuração do modelo e da complexidade do movimento.
Quais arquivos vou receber?
Você recebe o adaptador LoRA treinado em formato .safetensors, a palavra-chave de gatilho, instruções de uso e os clipes de teste incluídos no seu pacote. O modelo base completo LTX-2.5 não está incluso.
O adaptador funciona com todas as versões do LTX?
O adaptador é treinado para o fluxo de trabalho especificado do LTX-2.5. Compatibilidade com outras versões, check-points ou pipelines personalizados não é garantida.
O que inclui uma revisão?
Uma revisão cobre um ajuste dentro do escopo do pacote original, usando o conjunto de dados acordado e o modelo alvo. Um novo conjunto de dados, personagem adicional, versão do modelo diferente ou tarefa de treinamento substancialmente diferente exige uma cotação separada.
Posso usar o adaptador treinado comercialmente?
Uso e transferência estão sujeitos à licença do LTX-2.x. Vou incluir uma cópia da licença e avisos necessários com o adaptador. Entidades comerciais com receita anual de pelo menos US$ 10 milhões devem obter a licença paga exigida da Lightricks antes de usar o adaptador.
Quantas imagens de referência preciso fornecer?
Para melhores resultados, forneça de 20 a 40 imagens de alta qualidade do seu personagem. Inclua uma mistura de retratos próximos, planos médios, ângulos diferentes (frente, perfil 3/4), iluminação variada e alguns trajes diferentes para que a LoRA aprenda o rosto do seu personagem independentemente das roupas.
Essa LoRA funciona no meu setup local ou em nuvem ComfyUI?
Sim! Você vai receber o arquivo LoRA padrão .safetensors compatível com o transformador distilado LTX-2.5 22B no ComfyUI. Se precisar do nó exato, escolha o pacote Premium (ou adicione o Workflow Extra) e eu incluirei meu workflow do ComfyUI .json pronto para usar.
O LTX-2.5 gera vídeos no formato 16:9 horizontal e 9:16 vertical?
Com certeza. Informe a razão de aspecto preferida ao fazer o pedido e eu vou renderizar seus vídeos de amostra incluídos em 16:9 widescreen (1280x720) ou 9:16 vertical (720x1280) com áudio ambiente nativo.
Como evitar que o rosto sofra morfagem durante o movimento?
O LTX-2.5 responde melhor a prosa contínua e coreografia com marcação de tempo, onde o rosto da personagem fica visível na primeira cena. Junto com sua LoRA, eu forneço um modelo de prompt personalizado mostrando exatamente como estruturar seus prompts para travar a identidade ao máximo.