Ver categorias
Explorar
Fiverr Pro
Português
$
USD
Engenheiro de software de IA
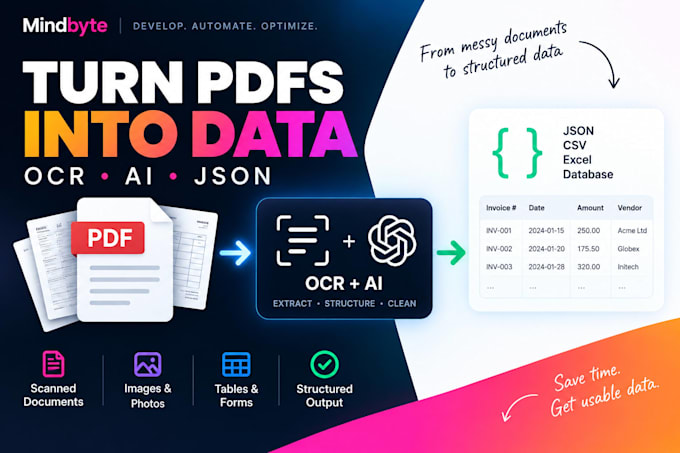
Eu crio pipelines de OCR e processamento de documentos que transformam PDFs, digitalizações e imagens em dados estruturados e utilizáveis.
Posso extrair texto, tabelas, datas, referências, IDs e campos personalizados, classificar documentos, limpar os resultados e retornar uma saída estruturada em JSON, CSV ou pronta para banco de dados.
Dependendo do projeto, também posso criar APIs, processamento assíncrono, busca semântica ou fluxos de trabalho RAG.
Meu foco é em processamento de documentos confiável e reutilizável, ao invés de simples conversões pontuais de PDF.
Por favor, envie amostras representativas de documentos antes de solicitar projetos complexos.
Tecnologia:
Python
Tradução automática
Você consegue processar PDFs escaneados?
Sim. Posso processar PDFs digitalizados e imagens, incluindo pré-processamento quando necessário.
Você consegue extrair campos específicos?
Sim. Datas, IDs, referências, títulos, tipos de documento e outros campos podem ser extraídos.
Você consegue classificar documentos?
Sim. A classificação pode usar regras, aprendizado de máquina ou IA, dependendo do caso de uso.
Você consegue extrair tabelas?
Sim, dependendo do layout do documento e da qualidade do scan.
Você consegue criar uma API ao redor do pipeline?
Sim. Pode-se adicionar API REST e processamento em background.
Você consegue processar grandes volumes?
Sim, mas workflows de alto volume geralmente requerem um escopo personalizado.
