Ver categorias
Explorar
Fiverr Pro
Português
$
USD


Tradução automática
Pare de pagar taxas mensais para a OpenAI e proteja seus dados com IA local 100% privada!
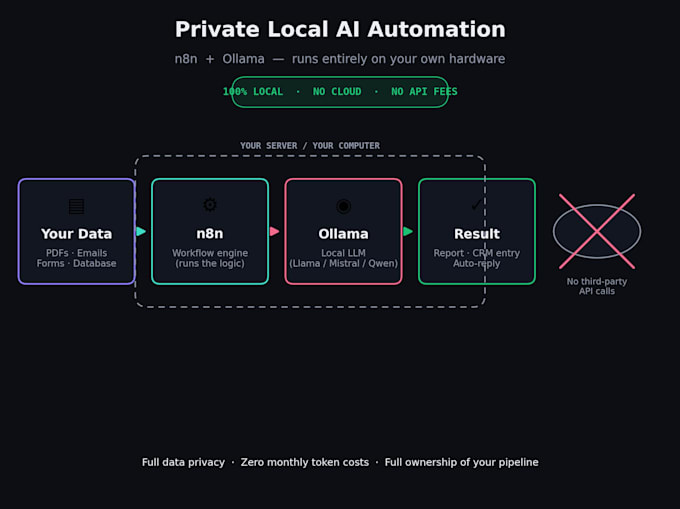
Quer automação de IA sem riscos de privacidade ou taxas caras de token? Eu construo Sistemas de IA auto-hospedados usando n8n + Ollama, rodando totalmente no seu hardware ou servidor privado.
Por que IA local?
100% privacidade dos dados, nada sai da sua infraestrutura
Zero custos de API, uso ilimitado de Llama 3, Mistral, Qwen, DeepSeek
Propriedade total do seu servidor, fluxos de trabalho e parâmetros de LLM
O que eu construo:
Como trabalhamos:
1️ Descoberta: definir objetivos e necessidades de segurança
2️ Configuração: configurar n8n + Ollama no seu hardware/VPS
3️ Construção: projetar, testar e otimizar sua lógica de IA
4️ Entrega: documentação completa + vídeo explicativo
AI Automation and Private LLM Specialist,n8n and Ollama Expert
Idiomas
Tradução automática
Tradução automática
Preciso de hardware potente para rodar isso localmente?
Depende do tamanho do modelo de IA. Modelos menores funcionam bem em uma CPU moderna ou GPU de médio porte. Para modelos maiores ou respostas mais rápidas, recomenda-se uma GPU (até mesmo uma de consumo como RTX 3060+). Vou revisar suas especificações durante a fase de Descoberta e recomendar o modelo adequado para sua configuração — sem adivinhações.
Não tenho um servidor — você ainda pode me ajudar?
Sim. Se você não tiver hardware local ou VPS, posso ajudar a configurar um (por exemplo, Hetzner, DigitalOcean, Contabo) como parte do projeto, ou recomendar um provedor que se encaixe no seu orçamento e necessidades.
Meus dados realmente vão permanecer privados?
Sim — com essa configuração, seus dados nunca deixam sua própria infraestrutura. Diferente das APIs de IA na nuvem (OpenAI, etc.), não há chamadas externas enviando seus dados para terceiros. Tudo roda localmente.
Um modelo open-source local (Llama, Mistral, Qwen) é tão bom quanto ChatGPT/GPT-4?
Para tarefas de negócios bem definidas (extração de documentos, pontuação de leads, perguntas internas), modelos locais funcionam muito bem e muitas vezes são "suficientes" ou melhores após ajustes para seu caso de uso. Eles não substituem chatbots de uso geral para todas as tarefas.
O que acontece após a entrega — posso fazer alterações sozinho?
Sim. Você receberá documentação completa e um vídeo explicativo de como o fluxo de trabalho funciona, para que você (ou sua equipe) possa fazer ajustes básicos de forma independente. Também estou disponível para suporte/manutenção contínuos, se preferir não gerenciar sozinho.
Quanto tempo a entrega demora?
O tempo de entrega depende do pacote e da complexidade do projeto — veja os níveis de preço acima. Integrações complexas (banco de dados, ajuste fino) levam mais tempo e estão refletidas nos pacotes Padrão/Premium.
E se o modelo não entender bem meus documentos/dados?
É exatamente para isso que serve a fase de Descoberta — testamos com uma amostra dos seus dados reais logo no início, para detectar problemas de precisão antes da entrega completa, e não depois.
Você oferece manutenção contínua após a entrega do projeto?
Sim, isso pode ser organizado separadamente como uma assinatura mensal, se você quiser que eu continue mantendo, atualizando ou estendendo seus fluxos de trabalho após a entrega.
