Ver categorias
Explorar
Fiverr Pro
Português
$
USD
Tradução automática
Por favor, envie uma mensagem antes de fazer o pedido - envie um documento de amostra e eu confirmarei o que é possível fazer.
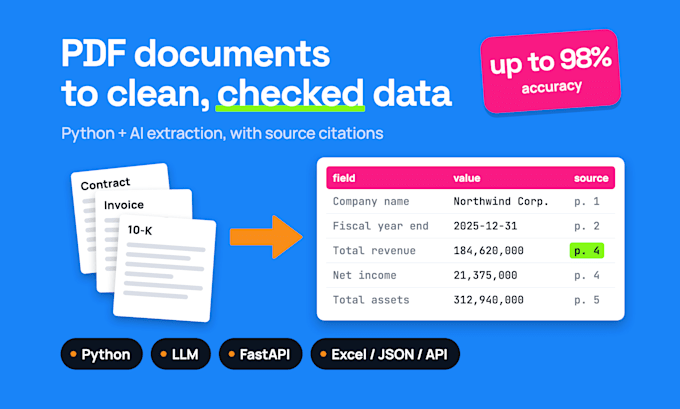
Ainda digitando números manualmente de PDFs? Faturas, contratos, pacotes de licitação, demonstrações financeiras: um número mal interpretado custa mais do que toda a extração.
Eu crio pipelines em Python que transformam seus documentos em tabelas limpas - e mostram de onde veio cada valor, para que você possa conferir ao invés de confiar cegamente.
O que você recebe:
Por que me escolher:
Não é indicado para trabalhos pontuais de copiar e colar que você consegue fazer com ChatGPT.
Envie uma mensagem com um documento de amostra e o que você precisa extrair dele.
Python AI developer, over 12 years in IT, document AI and RAG in production
Idiomas
Tradução automática
Tradução automática
Por que você deveria me escolher?
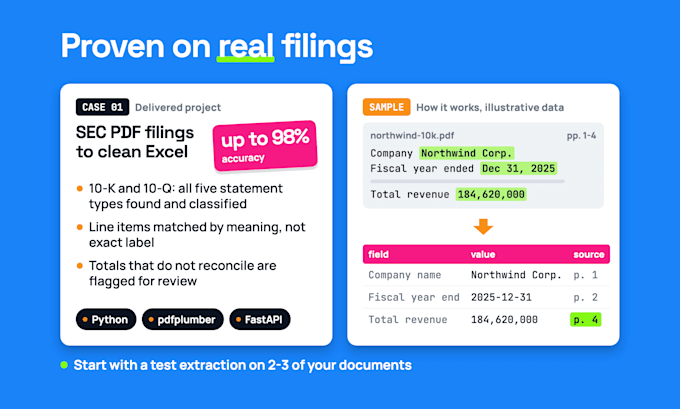
Eu construo extrações que você pode verificar: cada valor mantém sua página de origem, e valores que o sistema não tem certeza são sinalizados, não adivinhados. Prova: declarações SEC 10-K/10-Q extraídas para Excel com até 98% de precisão, mais de 12 anos em TI.
O que está incluído?
Os entregáveis do pacote, o código fonte (incluindo Docker), um relatório de precisão com seus próprios documentos de amostra e uma breve entrega escrita.
O que não está incluído?
Entrada manual de dados, custos de hospedagem, taxas da API de LLM e tipos de documentos não acordados na ordem. Tipos de documentos extras podem ser adicionados posteriormente como um adicional.
Meus dados estão seguros?
Sim. Estou disposto a assinar seu NDA antes de compartilhar qualquer documento. Uso seus arquivos apenas para este pedido e os excluo após a entrega.
Você pode testar com meus próprios documentos antes de fazer o pedido completo?
Sim, é para isso que serve o pacote Basic: eu faço a extração em 2-3 dos seus documentos e envio um relatório de precisão e um plano. Você decide pelo build completo só depois de ver números reais.
Quão preciso será e como você mede isso?
Depende dos seus documentos, então eu meço ao invés de prometer: cada campo extraído é comparado com o valor correto nas suas amostras, e você recebe a precisão por campo no relatório.
Você trabalha com PDFs escaneados (OCR)?
Sim. PDFs de texto são lidos diretamente; PDFs escaneados passam por OCR. A qualidade do escaneamento afeta a precisão, então PDFs escaneados são testados primeiro no pacote Basic com seus próprios arquivos, antes de você se comprometer com o build completo.
Você consegue extrair tabelas de PDFs?
Sim. Tabelas são o núcleo do meu trabalho com SEC 10-K/10-Q (demonstrativos financeiros). Cada tabela sai como linhas e colunas em Excel, CSV ou JSON, com a página de origem mantida para cada valor.
Quais formatos de saída você entrega?
Excel, CSV ou JSON por padrão. Com o extra Export To Sheet & DB, os dados vão direto para sua Google Sheet ou banco de dados.
Pode rodar no meu próprio servidor?
Sim. O pacote Premium é enviado em Docker, então o pipeline roda no seu próprio servidor e seus documentos permanecem com você.