Ver categorias
Explorar
Fiverr Pro
Português
$
USD
Especialista Sênior em Engenharia de Dados e Análise
Você precisa de uma pipeline ETL/ELT escalável ou de uma solução Medallion Lakehouse no Azure Databricks?
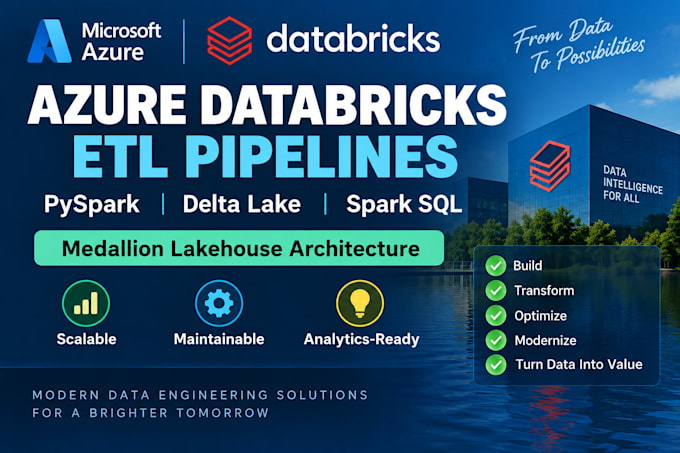
Eu vou criar e otimizar pipelines de dados no Azure Databricks usando PySpark, Spark SQL, Delta Lake e práticas modernas de engenharia de dados.
Posso ajudar com:
Pipelines ETL/ELT no Azure Databricks
Transformações com PySpark e Spark SQL
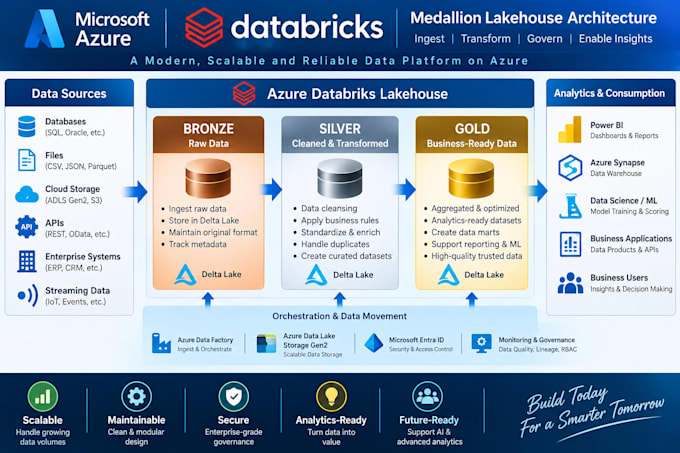
Arquitetura Bronze, Silver e Gold Medallion
Tabelas Delta Lake e processamento de dados
Integração de dados com ADLS Gen2
Limpeza, transformação e agregação de dados
Verificações de qualidade de dados e validação
Resolução de problemas e otimização de pipelines
Design de orquestração orientada ao ADF
Documentação e orientações de implementação
Minha abordagem
Foco em construir soluções de dados que sejam fáceis de manter, escaláveis e bem estruturadas, ao invés de apenas escrever código. Revisarei suas fontes de dados, regras de negócio, transformações, resultados esperados e requisitos técnicos antes de criar a solução.
Antes de fazer o pedido: Por favor, entre em contato para workloads complexos ou de produção e compartilhe suas fontes de dados, resultados esperados, arquitetura alvo, requisitos de transformação e detalhes do ambiente Azure.

Especialidade:
Automação
•
Outros
Provedor de nuvem:
microsoft azure
Tradução automática
FAQ 1 — Quais tipos de projetos no Azure Databricks você pode ajudar?
Posso ajudar com pipelines ETL/ELT, transformações com PySpark e Spark SQL, processamento Delta Lake, arquitetura Medallion Bronze-Silver-Gold, qualidade de dados, validação, resolução de problemas e otimização de desempenho.
FAQ 2 — Você consegue construir pipelines Bronze, Silver e Gold Medallion?
Sim. Posso projetar e construir pipelines Medallion onde Bronze armazena dados brutos, Silver realiza limpeza e transformações, e Gold prepara conjuntos de dados prontos para análise e relatórios.
FAQ 3 — Quais tecnologias você pode usar para esse serviço?
Dependendo do projeto, posso trabalhar com Azure Databricks, PySpark, Spark SQL, Delta Lake, ADLS Gen2, Azure Data Factory, SQL e Python.
FAQ 4 — Você consegue integrar Azure Data Factory com Databricks?
Sim. Posso apoiar designs de orquestração orientados ao ADF para ingestão de dados, acionamento de processamento no Databricks, gerenciamento de dependências e suporte a workflows ETL/ELT de ponta a ponta.
FAQ 5 — Você consegue otimizar uma pipeline PySpark ou Databricks já existente?
Sim. Posso revisar transformações, joins, particionamento, cache, comportamento de shuffle, design de tabelas Delta e outras áreas relevantes para identificar melhorias de desempenho adequadas.
FAQ 6 — Você precisa de acesso ao meu ambiente Azure ou Databricks?
Nem sempre. Código, dados representativos, detalhes da arquitetura, requisitos e resultados esperados podem ser suficientes para alguns projetos. O acesso ao ambiente pode ser discutido quando a implementação ou testes exigirem.
FAQ 7 — Você consegue trabalhar em projetos grandes ou de produção no Databricks?
Sim, mas por favor, entre em contato antes de fazer o pedido. Projetos com múltiplas fontes de dados, transformações complexas, implantação em produção, requisitos de segurança, orquestração ou cargas de trabalho grandes podem precisar de escopo e oferta personalizados.