Ver categorias
Explorar
Fiverr Pro
Português
$
USD
Engenheiro de Dados do Azure
Procurando um engenheiro de dados confiável no Azure para criar ou otimizar seus pipelines de ETL?
Posso ajudar você a criar soluções de dados escaláveis e eficientes usando Azure Data Factory (ADF), Azure Databricks, PySpark e Azure Data Lake Storage Gen2.
Seja para ingestão de dados, transformação, orquestração de workflows ou uma solução de ETL de ponta a ponta, posso entregar uma implementação limpa e fácil de manter, personalizada às suas necessidades.
O que você vai receber:
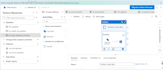
Desenvolvimento de pipelines no Azure Data Factory (ADF)
Ingestão de dados dinâmica e parametrizada
Transformações com Azure Databricks & PySpark
Desenvolvimento de pipelines ETL/ELT
Implementação da arquitetura Medallion
Validação da qualidade dos dados
Orquestração e monitoramento de pipelines
Documentação técnica
Visão geral do pacote:
Básico: pipeline simples de ingestão no ADF com 1 conector
Padrão: solução de ETL com ADF + Databricks, verificações de qualidade de dados e documentação
Premium: solução completa de ETL no Azure com orquestração, transformações e documentação completa
Tecnologias:
Azure Data Factory, Azure Databricks, PySpark, ADLS Gen2, Delta Lake, SQL, CSV e JSON.
Por favor, entre em contato antes de fazer seu pedido para discutir suas necessidades e escolher o melhor pacote.
Destination Platform:
Databricks Lakehouse
•
Outros
Ferramentas e plataformas:
Fábrica de dados do Azure
•
Outros
Tradução automática
Quais fontes de dados você consegue integrar?
Posso trabalhar com arquivos CSV, arquivos JSON, bancos de dados SQL, Azure Storage e outras fontes de dados suportadas pelo Azure Data Factory.
Você desenvolve pipelines do Azure Data Factory (ADF)?
Sim. Eu projeto e desenvolvo pipelines dinâmicos, parametrizados e escaláveis para ingestão de dados, orquestração e cargas de trabalho de ETL.
Você trabalha com Azure Databricks e PySpark?
Sim. Eu desenvolvo notebooks do Databricks e transformações com PySpark para limpeza, enriquecimento de dados e implementações de arquitetura Medallion.
Você pode modificar ou otimizar pipelines de ETL existentes?
Sim. Posso solucionar problemas, otimizar, melhorar e manter soluções existentes de Azure Data Factory e Databricks.
Quais informações você precisa antes de iniciar o projeto?
Compartilhe detalhes do seu sistema fonte, destino, requisitos de negócio, regras de transformação e saída esperada. Assim posso recomendar a melhor solução e pacote.
Qual pacote devo escolher?
O pacote Básico é adequado para pipelines simples de ingestão no ADF. Padrão é ideal para soluções de ETL com ADF + Databricks. Premium é recomendado para projetos completos de ETL no Azure com orquestração, transformações e documentação.
E se minhas necessidades não forem cobertas pelos seus pacotes?
Sem problema. Envie seus requisitos e posso recomendar o melhor pacote ou criar uma oferta personalizada com base no escopo do projeto.
Os custos de nuvem do Azure estão incluídos no preço do gig?
Não. O preço do gig cobre apenas os serviços de desenvolvimento e implementação. Quaisquer custos de assinatura do Azure ou infraestrutura de nuvem são responsabilidade do cliente.
Posso adicionar mais fontes de dados ou conectores?
Sim. Conectores adicionais podem ser adicionados através de Gig Extras ou uma oferta personalizada, conforme suas necessidades.
Vocês oferecem suporte após a entrega do projeto?
Sim. Ofereço suporte pós-entrega para questões relacionadas à solução entregue e também posso ajudar com melhorias futuras.


