Ver categorias
Explorar
Fiverr Pro
Português
$
USD

Tradução automática
Engenheiro de Backend IA | Pipelines RAG · Integração LLM · Sistemas agenticos
Sou um Engenheiro de Software Sênior com mais de 12 anos construindo sistemas de IA em produção. Sou o único arquiteto do Teqit, uma plataforma empresarial ao vivo com pipelines RAG, inferência de LLM local e microserviços agenticos atendendo mais de 10 clientes.
O que eu construo para você:
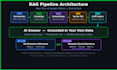
- Pipelines RAG para ingestão de documentos, busca vetorial, geração de respostas por LLM
- Integração de API de LLM com OpenAI, Claude, Gemini ou qualquer modelo hospedado
- Inferência local de LLM com Ollama / llama.cpp (reduz custos de IA em cerca de 70%)
- Ferramentas de workflows agenticos com chamadas de ferramenta, raciocínio em múltiplas etapas, pipelines de decisão
- Backends FastAPI ou Scala via REST ou gRPC
- Roteamento híbrido com troca inteligente entre modelos locais e na nuvem
Por que me escolher?
Já fiz isso em produção de verdade, não em tutoriais. Reduzi custos de IA em 70% com inferência local, criei pipelines de avatar gerativos de vídeo e projetei agentes que raciocinam de forma independente sobre bases de conhecimento empresarial.
Tecnologias: Python · FastAPI · Ollama · API OpenAI · Akka/Scala · Docker · AWS
Me envie uma mensagem antes de fazer o pedido, assim posso revisar seu caso de uso primeiro.
Senior AI and Backend Engineer
Idiomas
Tradução automática
Tradução automática
Você pode usar meus próprios documentos como base de conhecimento?
Sim — PDFs, documentos Word, arquivos de texto ou bancos de dados. Eu cuido de toda a ingestão e pipeline de chunking.
Posso hospedar isso no meu próprio servidor ou na AWS?
Com certeza. Eu configuro implantações com Docker + AWS EC2 e posso ajustar para qualquer provedor de nuvem.
Preciso de uma chave de API OpenAI?
Somente se você quiser modelos na nuvem. Para inferência local usando Ollama, não é necessário uma chave de API externa.
Você vai compartilhar o código fonte?
Sim — código fonte completo com documentação é entregue para todos os pacotes.
Você consegue integrar isso ao meu app existente?
Sim, desde que você compartilhe especificações de API ou acesso ao código. Me envie uma mensagem primeiro para discutir sua configuração.


