Ver categorias
Explorar
Fiverr Pro
Português
$
USD



Tradução automática
Seu aplicativo RAG encontra documentos, mas não a resposta, perde a estrutura do PDF ou oferece citações fracas?
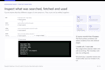
Eu sigo o caminho que falha através da extração, chunking, recuperação, montagem de contexto e links de fonte. Você recebe um diagnóstico reprodutível antes de se comprometer com uma reconstrução maior.
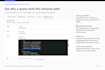
Meu assistente de pesquisa pessoal cobre 499 artigos e ~8M de tokens de corpus processados. Seu desenvolvedor rastreia e a recuperação guiada por gráficos são mostrados na galeria; estes são exemplos de projeto, não ganhos prometidos para o seu app.
BASIC $100: revisar um pipeline Python, 2 PDFs de amostra/20 páginas no total e 5 perguntas com falha. Achados escritos, plano de correção priorizado e revisão de 30 minutos. Sem alterações de código.
STANDARD: Básico mais uma correção de extração ou recuperação acordada, patch de fonte e 5 verificações de regressão.
PREMIUM: até 3 correções relacionadas naquele pipeline, 10 verificações, patches de fonte e entrega de entrega.
Uma revisão de esclarecimento para Basic/Standard; duas para Premium. Concordamos sobre o bug, configuração e verificações de aceitação primeiro. Rewrites completos, novos apps, migração de grande corpus e OCR complexo exigem escopo personalizado. Taxas de API/hosting são separadas.
Envie-me seu stack, 2 PDFs de amostra e as perguntas com falha.
RAG and Voice AI Developer
Idiomas
Tradução automática
Tradução automática
O pacote de $100 inclui uma correção de código?
Não. Básico entrega um diagnóstico reprodutível e um plano de correção priorizado para um pipeline, 2 PDFs/20 páginas e 5 perguntas, além de uma revisão de 30 minutos. Standard acrescenta uma correção acordada; Premium acrescenta até três correções relacionadas.
Você pode garantir respostas perfeitas ou uma latência específica?
Não. Concordamos nas perguntas com falha representativas e verificamos os resultados antes e depois de uma correção no escopo. Escolhas de modelo, corpus e hosting afetam o comportamento. O showcase com 8M tokens é evidência do meu trabalho, não da capacidade do seu pacote nem garantia de precisão.
Quais sistemas você pode revisar?
Sistemas Python RAG usando FastAPI, LangChain, LangGraph, LlamaIndex e bancos de dados vetoriais como Qdrant. Envie o stack relevante e notas de configuração primeiro para eu confirmar o encaixe. Este serviço é para um pipeline existente, não para uma nova aplicação.
Que acesso e custos são necessários?
Forneça um exemplo reproduzível mínimo, documentos de amostra e logs sanitizados. Não cole keys secretas ou senhas no chat. Concordamos com um método de acesso apropriado se necessário. Taxas de API, modelo, banco de dados e uso de hosting são separadas.


