Ver categorias
Explorar
Fiverr Pro
Português
$
USD
Tradução automática
Seu chatbot RAG parecia bem na demonstração. Aí os usuários reais começaram a fazer perguntas reais e agora ele dá respostas incorretas com total confiança.
Normalmente o problema não é o modelo. É a recuperação, o chunking ou o texto que saiu do OCR com erro. eu descubro qual é, com números em vez de suposições.
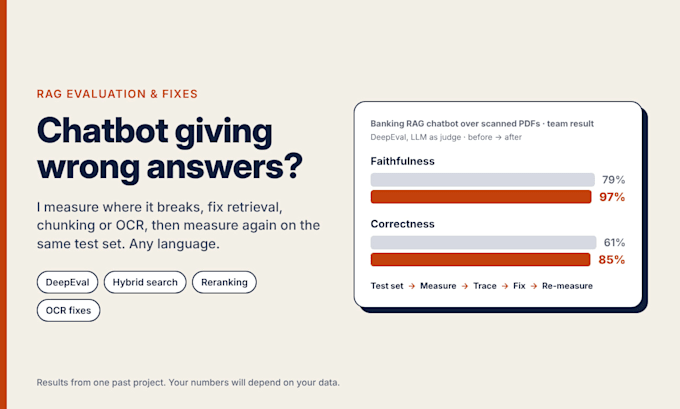
Esse é o trabalho que eu mais conheço. Em um chatbot bancário sobre PDFs digitalizados na GBG, medimos a fidelidade em 79%. Depois de corrigir o OCR e adicionar busca híbrida, reclassificação e reescrita de consultas, chegou a 97%, e a exatidão passou de 61% para 85% (DeepEval, LLM como juiz).
Como funciona:
1. eu gero um conjunto de testes a partir dos seus documentos e perguntas reais de usuários
2. eu avalio fidelidade, exatidão e qualidade de recuperação
3. eu identifico a causa de cada falha: parsing, chunking, search, classificação ou prompt
4. você recebe um plano de correção, ou eu faço as correções e avalio de novo
Você recebe um relatório curto com números antes e depois no mesmo conjunto de testes. Não prometo um número específico, já que depende dos seus dados.
Funciona com LangChain, LlamaIndex ou pipelines Python simples, em qualquer idioma em que seus documentos estejam.
Envie-me alguns exemplos de respostas ruins. Muitas vezes isso já basta para eu te dizer onde olharia primeiro.
AI Engineer building RAG systems, LLM agents and Arabic NLP
Idiomas
Tradução automática
Tradução automática
Você precisa de acesso ao meu código?
Para a auditoria, um endpoint de API funcionando ou acesso de leitura já basta. Para fazer as correções eu preciso do código, idealmente um repositório privado no Git em que você me convide. Não preciso de senhas de produção.
Você pode prometer um número de exatidão específico?
Não, e eu tomaria cuidado com quem promete. Depende dos seus documentos e perguntas. O que eu prometo são pontuações honestas de antes e depois no mesmo conjunto de testes, para você ver exatamente o que melhorou.
Quais ferramentas você usa para avaliação?
Na maioria das vezes DeepEval com um juiz de IA, mais checagens para ver se as chunks corretas foram recuperadas. Se você já usa RAGAS ou seu próprio setup, eu consigo trabalhar com isso.
A língua dos meus documentos importa?
O processo é o mesmo. A língua afeta principalmente OCR, divisão de texto e qualidade de busca, e eu verifico esses pontos especificamente. Já trabalhei mais com árabe e inglês. Diga a sua e eu digo honestamente se é compatível.
E se a correção real for uma arquitetura diferente?
Então o relatório diz isso, com uma estimativa aproximada, antes de eu escrever qualquer código. Você decide o que acontece a seguir.
