Ver categorias
Português
$
USD
Conecte-se à sua IA
Engenheiro de dados
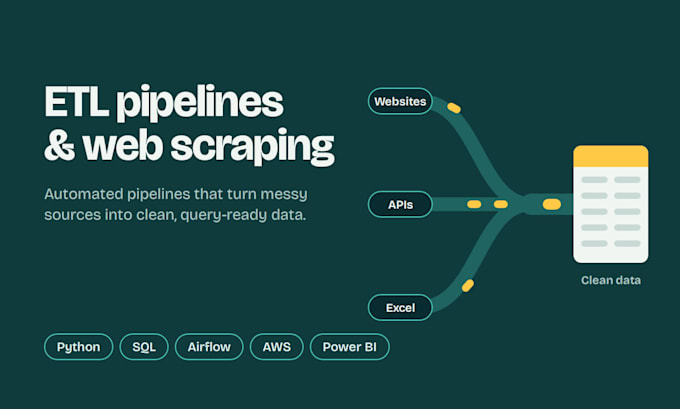
Precisa de dados de sites, ou tem dados mas não um sistema confiável para movê-los? Planilhas, APIs e bancos de dados que nunca batem, relatórios refeitos à mão toda semana, pipelines que quebram da noite para o dia? Eu resolvo isso.
Sou um Data Engineer com 4 anos de experiência e um MSc em Big Data Analytics do Reino Unido. Atualmente sigo construindo pipelines de produção para grandes marketplaces online, incluindo tabelas de fato incrementais no Redshift com mais de 20M de registros.
O que eu buildo:
Por que eu? experiência real de produção, código limpo documentado que você possui e atualizações claras em cada etapa.
Por favor, me mande uma mensagem antes de pedir para eu entender direito o seu projeto.
Tradução automática
Com quais ferramentas você trabalha?
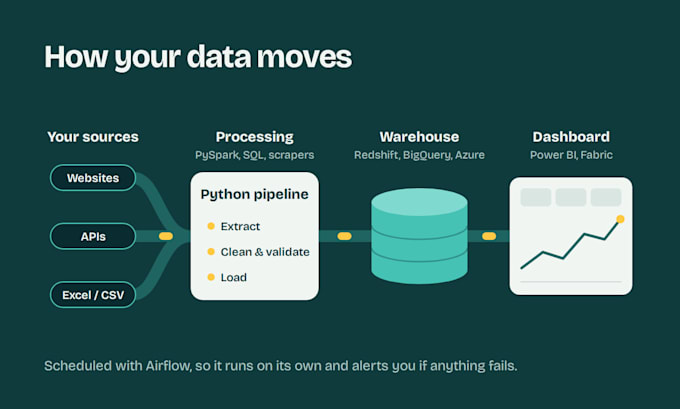
Python, SQL, PySpark, Apache Airflow, Matillion, Talend, AWS (Redshift, Lambda), Azure, Google BigQuery e Power BI, além de BeautifulSoup, Requests, Selenium, Scrapy e Playwright para web scraping.
Você consegue raspar sites que carregam conteúdo com JavaScript?
Sim. Para sites dinâmicos eu uso ferramentas de automação de navegador como Selenium ou Playwright, em vez de apenas fazer requisições simples de página.
Você pode trabalhar com meu pipeline existente?
Sim. Posso depurar, otimizar ou ampliar pipelines que você já tem, incluindo corrigir registros duplicados ou ausentes.
Em que formato receberei meus dados?
CSV, Excel, JSON, Google Sheets, ou carregado diretamente no seu banco de dados ou data warehouse.
Eu sou o proprietário do código?
Sim. Você recebe o código-fonte completo, e Standard e Premium também incluem documentação.
Você consegue fazer scraping de qualquer site?
Eu raspo apenas dados publicamente disponíveis. Não raspo redes sociais ou qualquer coisa atrás de login sem permissão, pois isso vai contra as regras da Fiverr.
Você consegue construir pipelines em tempo real?
Pipelines em batch agendadas são minha oferta principal. Para necessidades em tempo real, me manda uma mensagem primeiro que vamos verificar se cabe.