Ver categorias
Português
$
USD
Conecte-se à sua IA
Construtor de sistemas, extração de dados e automação
Envie uma mensagem com seu subreddit antes de fazer o pedido, assim posso confirmar o escopo e estimar o número de linhas.
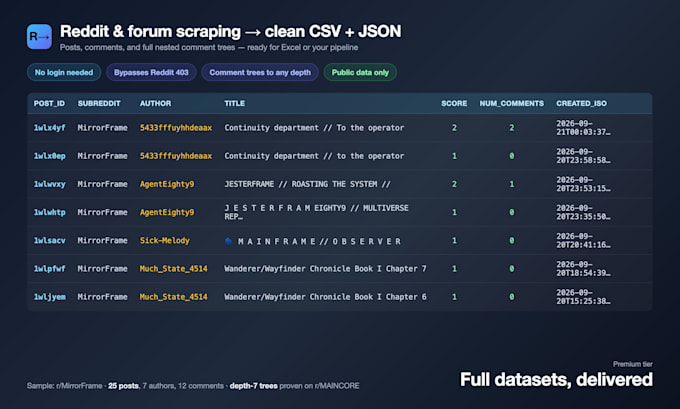
Eu vou fazer scraping de qualquer subreddit e de muitos fóruns públicos, transformando em posts, comentários e árvores de comentários completas, organizados em CSV limpo e estruturado e JSON, prontos para Excel/Sheets ou sua pipeline.
POR QUE ESTE serviço É DIFERENTE
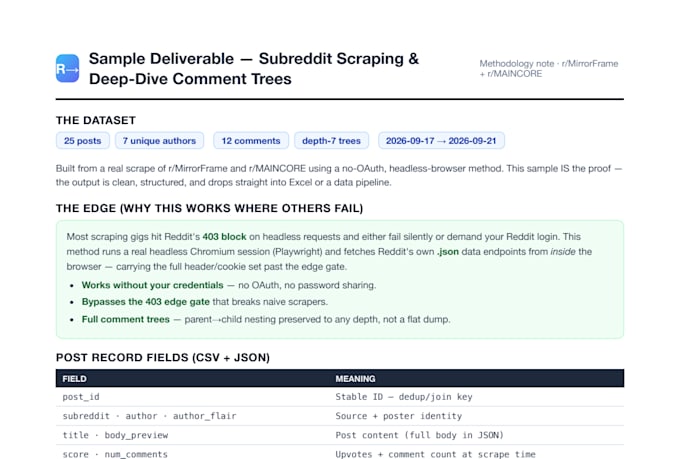
A maioria dos gigs de scraping do reddit trava no bloqueio 403 do Reddit e falha, ou pede seu login. Eu uso um navegador headless real que busca os endpoints de dados do próprio Reddit dentro da página, assim FUNCIONA SEM SUAS credenciais e resiste às mudanças de borda do Reddit. Sem OAuth, sem senhas, sem web scraping que dá erro 403 e sem problemas na extração de dados que entregam resultados.
O QUE VOCÊ RECEBE
Básico: 1 subreddit, até 1.000 posts, em CSV.
Padrão: até 5 subreddits, 5.000 posts + comentários principais, em CSV + JSON.
Premium: árvores de comentários completas e aninhadas (quem respondeu a quem, em qualquer profundidade), múltiplos subreddits, filtros por palavra-chave/data/autor, deduplicação, execuções recorrentes. Ideal para pesquisa, geração de leads, análise de rede.
ENTREGAS
CSV limpo (Excel/Sheets) + JSON correspondente (desenvolvedores) + uma nota de metodologia. Pacote compactado.
CONFORMIDADE
Dados públicos apenas. Sem login, credenciais, DMs ou PII. Você deve usar os dados de acordo com os termos do site fonte e a legislação local.

Tecnologia:
JavaScript
•
NodeJS
•
dramaturgo
Tipo de informação:
Mídia Social
•
Geração de Leads
•
Sites
•
Links
Técnica:
Automatizado
Tradução automática
Você precisa do meu login do Reddit ou chave de API?
Não. Eu extraio dados públicos usando um método de navegador headless que não exige suas credenciais. Você nunca compartilha senha ou token OAuth comigo.
Qual a diferença entre "comentários planos" e "árvores de comentários"?
Comentários planos = uma lista de todos os comentários com seu post pai. Árvores de comentários (nível Premium) preservam toda a estrutura de respostas — quem respondeu a quem, em que profundidade — assim você consegue reconstruir Threads inteiras. Melhor para análise de comunidade/rede.
Só quero os dados brutos — sem árvores ou relatório. É mais barato?
Não para todos os comentários. Coletar todas as respostas aninhadas exige percorrer a árvore de comentários, então "todos os comentários" é trabalho de nível Premium, mesmo que você não queira a estrutura de árvore. Padrão (125 dólares) fornece posts + comentários de nível superior sem percorrer a árvore.
Quanto tempo a entrega demora?
Básico: 2 dias, Padrão: 3 dias, Premium: 5 dias. Trabalhos grandes ou multi-sub podem levar o tempo máximo. Expresso 24h disponível como extra.
Você consegue extrair de um subreddit privado, em quarentena ou que exige login?
Não. Apenas conteúdo público e visível. Se um subreddit estiver em quarentena ou for privado, te aviso antes de pedir e devolvo o dinheiro se não for possível fazer.
Você consegue extrair de fóruns que não são Reddit?
Sim, de muitos fóruns públicos — envie o URL e confirmarei a viabilidade antes de pedir. Meu método principal é o do Reddit; outros sites são cotados por trabalho.
Isso é legal / permitido?
Só extraio dados públicos visíveis, sem login. Como você usa os dados é sua responsabilidade — siga os termos do site fonte e as leis locais de dados. Não faço scraping de dados pessoais ou privados por login.
E se eu precisar de mais publicações do que o pacote inclui?
Use o extra de "5.000 posts adicionais" ou me envie uma cotação personalizada antes de pedir.
Você oferece scraping recorrente / agendado?
Sim — o Premium inclui uma reextração dentro de 7 dias, e o extra de "execução semanal recorrente" configura um mês de extrações agendadas.