Ver categorias
Explorar
Fiverr Pro
Português
$
USD
Tradução automática
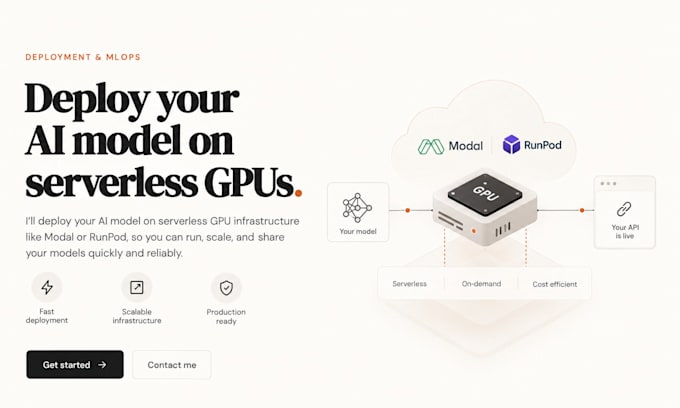
Eu crio e otimizo backends de inferência de IA para aplicativos que precisam de computação real na GPU, não apenas uma camada em volta da API do ChatGPT.
Já implementei e otimizei pipelines de IA em produção (processamento de imagem/vídeo, modelos generativos estilo face-swap) na infraestrutura serverless de GPU da Modal, incluindo:
- Configuração de instâncias GPU/CPU (L4/T4) ajustada para equilibrar custo e latência
- Otimização de cold-start e warmup para reduzir o tempo de GPU desperdiçado
- Snapshot de memória da GPU para diminuir o tempo de cold-start
- Otimização de pipeline com redução de cerca de 75% no tempo de processamento em uma carga de trabalho de produção
- Tratamento de sinais e melhorias na confiabilidade para trabalhos de inferência de longa duração
Mobile App Developer
Idiomas
Tradução automática
