Ver categorias
Explorar
Fiverr Pro
Português
$
USD
Engenheiro de Visão Computacional, YOLO e Implantação em Tempo Real
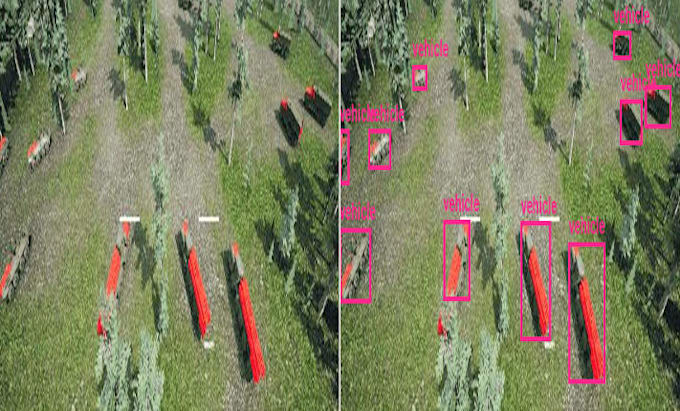
Anotação precisa de caixas delimitadoras e polígonos para dados de treinamento de visão computacional, entregues no formato que sua pipeline espera.
Sou engenheiro de visão computacional, não um contratante de rotulagem. Isso fica evidente nos casos extremos: objetos ocultos, limites de classe ambíguos e instâncias próximas ao limite de resolução. Rotulo do jeito que um modelo precisa ser ensinado, e marco as decisões que você deve tomar, ao invés de adivinhar silenciosamente por você.
O QUE VOCÊ RECEBE
Caixas delimitadoras ou máscaras de segmentação de polígonos
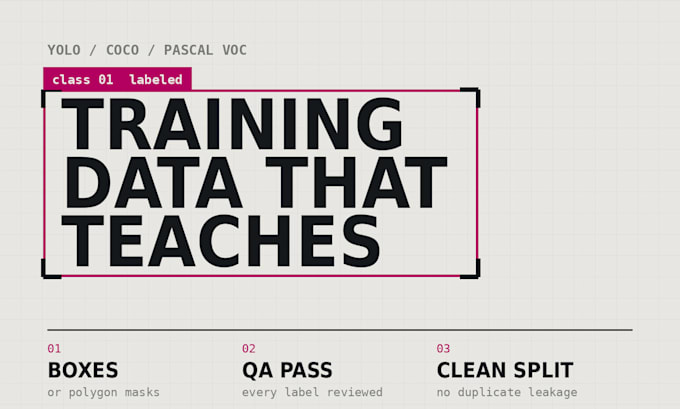
Exportação em YOLO, COCO JSON ou Pascal VOC XML
Resumo da distribuição de classes para você ver o desequilíbrio antes de treinar
Notas sobre casos ambíguos e como os resolvi
Os pacotes Standard e Premium incluem uma revisão de QA em segunda passagem de cada anotação.
O pacote Premium inclui uma divisão segura de treino, validação e teste, agrupada de modo que quadros quase duplicados não fiquem em ambos os lados e inflacionem sua pontuação de validação.
A extração de quadros de vídeo está incluída sem custo adicional. Envie a filmagem bruta e sua taxa de amostragem.
Me envie uma mensagem com a quantidade de imagens e a lista de classes para uma cotação exata.

Técnica:
Manual
Tipo de marcação:
Imagem
•
Vídeo
Tradução automática
Como você mantém a consistência na rotulagem em milhares de imagens?
Escrevo uma diretriz de rotulagem curta antes de começar, cobrindo o que conta como uma instância, como lidar com o oclusão e o tamanho mínimo do objeto, e envio para você aprovar. A consistência vem de decidir as regras uma vez, de antemão, e não caso a caso.
Você pode anotar vídeo?
Sim. Envie a filmagem bruta e sua taxa de amostragem, e eu extraio quadros sem custo adicional. Quadros de um mesmo vídeo são quase duplicados, então agrupo eles ao dividir para evitar que fiquem em ambos os lados de treino e validação.
Meus dados são mantidos confidenciais?
Sim. Seus dados são usados apenas para seu projeto, armazenados localmente durante o trabalho e deletados a pedido após a entrega. Posso assinar um NDA antes de você enviar qualquer coisa.
E se eu discordar de algumas etiquetas?
Me envie os arquivos específicos e o que você faria diferente. Revisarei esses e atualizarei a diretriz para que a mesma decisão seja aplicada ao restante do conjunto. Revisões estão incluídas em todos os pacotes.