Ver categorias
Explorar
Fiverr Pro
Português
$
USD
Analista de Dados Python e Machine Learning
Você quer extrair valor de negócio dos seus dados brutos ou implantar modelos de aprendizado de máquina preditivos precisos? Eu ofereço soluções completas de aprendizado supervisionado em Python, personalizadas para seus objetivos exatos.
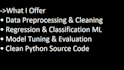
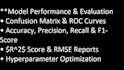
O que eu ofereço:
Pilha tecnológica:
Python | Scikit-Learn | Pandas | NumPy | Seaborn | Matplotlib
Por que me escolher?
Por favor, envie uma mensagem com seu dataset e requisitos do projeto antes de fazer o pedido
Linguagem de programação:
Python
Frameworks:
Scikit-learn
Ferramentas:
Excel
Tradução automática
O que você precisa de mim para começar?
Preciso do seu dataset (em .csv, .xlsx ou xls) e uma breve descrição do seu objetivo, incluindo qual variável alvo você quer prever.
E se meu dataset precisar de uma limpeza pesada ou tratamento de dados ausentes?
Pré-processamento completo de dados e engenharia de features estão incluídos em todos os pacotes (Básico, Padrão e Premium) antes de treinar qualquer modelo de aprendizado de máquina.
Quais entregáveis receberei ao final?
Você receberá scripts Python limpos e totalmente documentados (.py), arquivos do modelo treinado (.pkl / .joblib) e relatórios visuais de avaliação (gráficos e resumo de métricas).
E se meu dataset precisar de uma limpeza pesada ou tratamento de dados ausentes?
Pré-processamento completo de dados e engenharia de features estão incluídos em todos os pacotes (Básico, Padrão e Premium) antes de treinar qualquer modelo de aprendizado de máquina.