Ver categorias
Explorar
Fiverr Pro
Português
$
USD
Desenvolvedor Python, Especialista em Raspagem de Web e Análise de Dados
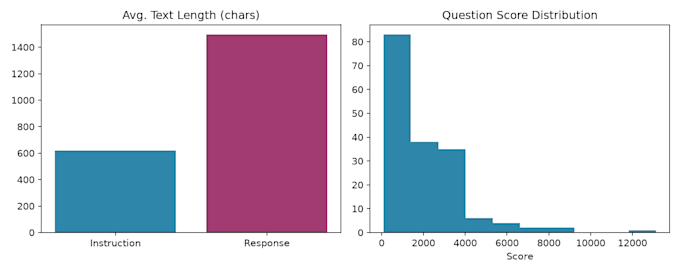
Precisa de dados de perguntas e respostas limpos e estruturados para ajustar ou treinar um modelo de IA/LLM?
Eu crio pipelines de coleta de dados que puxam pares de perguntas e respostas de fontes públicas baseadas em API (não scraping frágil de HTML), limpam o texto, filtram conteúdos de baixa qualidade ou contendo PII, e entregam JSONL de instrução/resposta pronto para uso, no formato exato usado para ajustar modelos como GPT e Llama.
O que você recebe:
Eu uso APIs públicas oficiais ao invés de raspar sites que proíbem isso (como Reddit/Quora), assim seu dataset fica limpo, legal e confiável.
Me diga seu tópico/domínio e quantos registros você precisa, e eu confirmarei o escopo antes de você fazer o pedido.

Especialidade:
Outros
Linguagem de programação:
Python
Ferramentas:
caderno Jupyter
Tradução automática
De quais fontes você coleta?
APIs públicas e documentadas (exemplo: Stack Exchange) que permitem explicitamente esse tipo de coleta — não plataformas de scraping que proíbem isso.
Em que formato os dados serão entregues?
JSONL (pares de instrução/resposta), o formato padrão para ajuste de LLM. CSV/JSON também disponível mediante solicitação.
Você consegue fazer um tópico/domínio personalizado?
Sim — envie uma mensagem com seu tópico e quantidade de registros desejada antes de fazer o pedido, assim posso confirmar a viabilidade.