Ver categorias
Explorar
Fiverr Pro
Português
$
USD
Especialista em Machine Learning e NLP
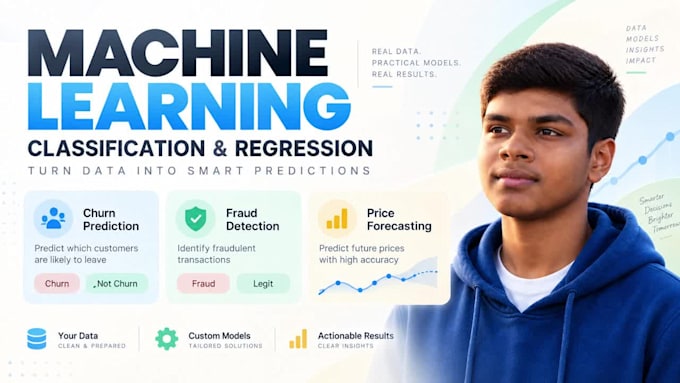
Precisa de um modelo confiável de aprendizado de máquina para classificação, regressão ou previsão?
Portfólio: https://kawsar-portfolio-kawsar07ahmmed0712-5454.vercel.app/
Eu crio soluções de aprendizado de máquina limpas e práticas para dados estruturados e tabulares usando Python.
O que posso ajudar:
Ferramentas que uso:
Scikit-learn, XGBoost, LightGBM, CatBoost, Pandas, NumPy, Jupyter Notebook e TensorFlow quando necessário.
Você receberá código fonte limpo, um modelo treinado, resultados de avaliação, visualizações e documentação clara. Os pacotes Padrão e Premium incluem ajustes mais profundos e comparação de modelos, enquanto o Premium também pode incluir integração com API Flask.
Por favor, envie uma mensagem com seu conjunto de dados e objetivo do projeto antes de fazer o pedido, assim posso recomendar o pacote mais adequado.
Obrigado,
Kawsar Ahmmed




Linguagem de programação:
Python
•
SQL
•
Colab
Frameworks:
Scikit-learn
•
keras
•
PyTorch
•
Panda
•
Outros
Ferramentas:
caderno Jupyter
•
fluxo tensor
•
Excel
•
Colab
Tradução automática
Que tipo de conjuntos de dados você pode trabalhar?
Eu trabalho principalmente com conjuntos de dados estruturados ou tabulares, como arquivos CSV e Excel contendo features numéricas ou categóricas. Se você não tiver certeza se seu conjunto de dados é adequado, envie uma mensagem antes de fazer o pedido.
Preciso saber se meu problema é classificação ou regressão?
Não. Basta explicar o que você quer prever, e eu revisarei sua variável alvo e recomendarei a abordagem de aprendizado de máquina mais adequada.
Como você escolhe o modelo de aprendizado de máquina certo para meus dados?
Eu comparo algoritmos adequados com base no seu conjunto de dados, tipo de problema e métricas de avaliação. Dependendo do projeto, posso usar modelos como Regressão Logística ou Linear, Random Forest, XGBoost, LightGBM, CatBoost, SVM ou KNN.
O que receberei com meu pedido?
Dependendo do pacote, você receberá código fonte limpo em Python, um Jupyter Notebook, fluxo de trabalho de pré-processamento, modelo treinado, resultados de avaliação, visualizações relevantes e documentação do modelo.
Você consegue trabalhar com conjuntos de dados bagunçados ou desequilibrados?
Sim. Posso lidar com problemas comuns como valores ausentes, features categóricas, escalonamento, engenharia de features e desequilíbrio de classes usando técnicas de pré-processamento apropriadas.
Você consegue garantir uma precisão ou desempenho específico?
Nenhuma precisão fixa pode ser garantida, pois o desempenho do modelo depende da qualidade, tamanho, equilíbrio e informações preditivas do conjunto de dados. Utilizarei validação adequada, métricas e métodos de otimização para alcançar um resultado confiável.
Você oferece integração de API para o modelo treinado?
Sim. O pacote Premium pode incluir integração com API Flask para que o modelo treinado aceite entradas e retorne previsões via API. Implantação na nuvem não está incluída, a menos que seja acordado separadamente.