Ver categorias
Explorar
Fiverr Pro
Português
$
USD
Engenheiro de dados
Você está enfrentando consultas lentas no BigQuery, modelos dbt quebrados ou jobs Spark não otimizados?
Sou um Engenheiro de Dados Sênior (Certificado Associado da Databricks) com mais de 5 anos de experiência construindo e otimizando arquiteturas de dados escaláveis na nuvem (GCP, Databricks, BigQuery). Especializo-me em transformar pipelines de dados complexos, lentos e caros em fluxos de trabalho rápidos, eficientes e econômicos.
O que posso fazer por você:
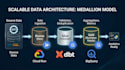
- dbt & Data Warehousing: Construir e refatorar modelos dbt seguindo a arquitetura Medallion (Bronze, Silver, Gold), otimizar consultas SQL e configurar execuções no Cloud Run / Control-M / Airflow.
- PySpark & Databricks: Depurar, refatorar e acelerar pipelines ETL em batch com Spark (Scala/Python).
- Arquitetura de Nuvem GCP: Configurar pipelines escaláveis com BigQuery, Cloud Run e Airflow/Composer.
- Otimização de Banco de Dados & Consultas: Reduzir custos de processamento e tempos de execução no BigQuery/Snowflake.
Por que trabalhar comigo?
- Expertise Certificada: Engenheiro de Dados Certificado da Databricks & Certificado Azure.
- Código de Alta Qualidade: Práticas de engenharia de dados limpas, modulares e fáceis de manter.
- Comunicação Clara & Direta: Disponível em inglês e espanhol.
OBS: Entre em contato comigo com seus requisitos antes de fazer seu pedido

Tradução automática
Você aceita pedidos personalizados de longo prazo?
Sim, mas apenas para micro-tarefas específicas ou consultoria de meio período. Por favor, envie uma mensagem primeiro para discutir os detalhes.
O que preciso fornecer antes de começar?
Acesso ao ambiente na nuvem (ou dados/código de amostra anônimos) e uma descrição clara do resultado esperado/logs de erro.
Podemos agendar uma ligação para discutir o projeto?
Sim, via recurso de videochamada do Fiverr assim que um pedido ou solicitação for iniciado.


